scieneers
  • Story
  • Leistungen
    • Leistungen allgemein
    • KI für die Energiewirtschaft
    • Große Sprachmodelle für Ihre Daten
    • Erweiterbare AI-Chat-Basis
    • Azure über CSP beziehen
    • Microsoft Fabric Data Platforms
    • Social Impact @ scieneers
  • Workshops
    • Datenprodukt-Strategie Workshop
    • Microsoft Data Strategy & Analytics Assessment
    • Azure Data Platform Proof of Concept
    • Retrieval-Augmented Generation
    • Microsoft Fabric: „Bring Your Own Data“ Workshop
    • Power BI Training
    • Fabric Analyst in a Day
  • Content
  • Team
  • Join
  • Kontakt
  • DE
  • EN
  • Menü Menü

Time Series Foundation Models in Practice

Dateneffizienz, Transferlernen und Robustheit anhand realer Fernwärmedaten

Einmal täglich muss der Wärmeerzeuger entscheiden, wie die Anlage in den kommenden Tagen betrieben werden soll. Diese Entscheidung basiert auf einer Prognose des Wärmebedarfs, die vier Tage in 15-Minuten-Schritten umfasst und insgesamt 384 Werte enthält. Der erste Tag dient als Grundlage für den Plan, die anderen drei Tage dienen als Puffer für den Fall, dass die nächste Prognose fehlschlägt. Ein Optimierer entscheidet dann, welche Erzeugungseinheiten wann in Betrieb genommen werden. Ist die Prognose zu niedrig, droht eine Unterversorgung im Netz. Ist sie zu hoch, wird Wärme erzeugt, die niemand benötigt.

In diesem Beitrag geht es um die Frage, ob eine neue Klasse von Modellen, sogenannte Zeitreihen-Foundation-Models, diese Prognoseaufgabe besser erfüllen kann als die derzeit eingesetzten Verfahren.

📑 Inhaltsverzeichnis

  • Der Ausgangspunkt
  • Was ein Zeitreihen-Grundmodell ist
  • Der Versuchsaufbau
  • Ergebnis 1: Chronos-2 ist das genaueste Modell
  • Ergebnis 2: Es sind keine Trainingsdaten erforderlich
  • Ergebnis 3: Robust – in zweierlei Hinsicht
  • Was wir daraus lernen
  • Unsere Auswirkungen

Der Ausgangspunkt

In der Produktion spielen zwei Modellfamilien eine Rolle. Ein CNN-LSTM, ein neuronales Netzwerk, das anhand der historischen Daten des eigenen Netzes trainiert wurde, funktioniert gut, benötigt jedoch zwei bis drei Jahre aufgezeichnete Daten, um ausreichend trainiert zu werden. Derzeit wird AutoARIMA eingesetzt, ein statistisches Modell, das ebenfalls die Wettervorhersage nutzt. Es benötigt keinen Trainingsdatensatz, sondern lediglich die Daten der letzten Wochen, auf deren Grundlage es seine Vorhersagen erstellt.

Foundation Models versprechen mehr als beide. Ihre Autoren präsentieren sie als universelle Prognosemodelle, die mit minimalen Anpassungen auf nahezu jedem realen Datensatz einsetzbar sind. Daher haben wir zwei Fragen gestellt: Trifft diese Behauptung auf echte Betriebsdaten zu? Und würden sie die im Einsatz befindlichen Modelle tatsächlich in Bezug auf Genauigkeit, Zuverlässigkeit und Toleranz gegenüber fehlerhaften Sensordaten übertreffen?

Die kurze Antwort, mit dem Vorbehalt, dass es sich um eine Offline-Studie handelt, lautet: Bei einem der drei Modelle eindeutig, bei einem teilweise und bei einem nicht.

Back-in-time Back-in-time

Was ein Zeitreihen-Grundmodell ist

Dieses Prinzip ist aus Sprachmodellen bekannt. Anstatt ein Modell für eine bestimmte, eng gefasste Aufgabe von Grund auf neu zu trainieren, nutzt man ein Modell, das bereits auf einem riesigen und vielfältigen Korpus vortrainiert wurde, und wendet es auf etwas Neues an. Zeitreihen-Foundation-Models wenden diesen Ansatz auf Prognosen an. Sie werden auf Millionen von Zeitreihen vortrainiert und lernen so die allgemeine Struktur sequenzieller Daten kennen: Tägliche und wöchentliche Muster, Trends sowie die Reaktion einer Zeitreihe auf externe Faktoren wie das Wetter.

Dieses Vortraining ist nicht rein abstrakt. LOTSA, eines der Vortrainingsarchive, umfasst rund 27 Milliarden Beobachtungen, von denen etwa 59 % aus dem Energiebereich stammen. Unsere Fernwärmenetze waren zwar nicht enthalten, aber höchstwahrscheinlich andere Zeitreihen, die sich ihnen sehr ähnlich verhalten.

Die Verwendung eines solchen Modells ohne jegliches Training an den Zieldaten wird als Zero-Shot bezeichnet, und genau das macht diese Modelle in Szenarien mit geringen Datenmengen so interessant.

Wir haben drei davon getestet: Chronos-2 (Amazon), TimesFM-2.5 (Google) und Moirai-2 (Salesforce). Jedes Modell wurde im Zero-Shot-Verfahren und nach einem parametereffizienten Fine-Tuning anhand der eigenen Netz-Daten ausgeführt. Einige Varianten nutzen zusätzlich Xreg, eine Technik, die wir aus der Referenzimplementierung von TimesFM übernommen haben. Dabei handelt es sich um eine kleine lineare Regression auf die Wetter- und Kalender-Kovariaten, die auf die Fehler des Foundation Models angepasst wird. TimesFM-2.5 benötigt diese Technik, um Kovariaten überhaupt nutzen zu können, da das Modell selbst nur die Nachfragehistorie auswertet. Chronos-2 kann Kovariaten hingegen direkt verarbeiten, weshalb Xreg für dieses Modell ein alternativer Ansatz ist. Den Foundation Models standen vier Baseline-Modelle gegenüber: AutoARIMA als Produktionsreferenz, XGBoost als leistungsstarkes Machine-Learning-Modell, eine Ridge-Regression (eine regularisierte lineare Regression) und naive Persistenz, welche lediglich den zuletzt bekannten Eingabewert als flache Linie wiederholt. Ein Modell, das eine flache Linie nicht übertreffen kann, ist in der Praxis nicht verwendbar.

Der Versuchsaufbau

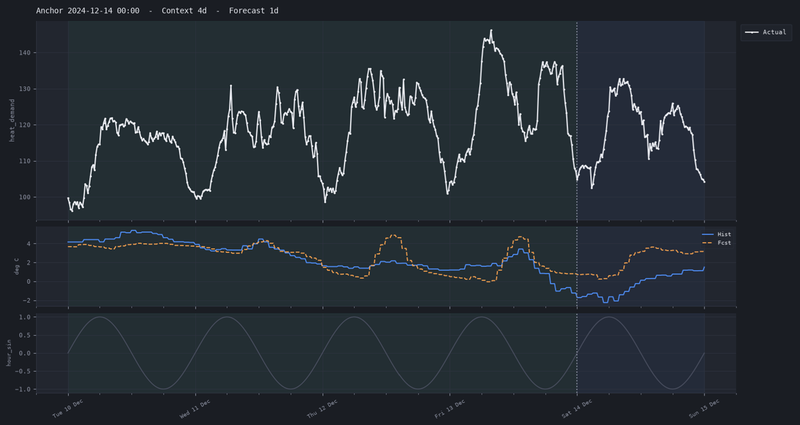
Diagramm mit drei Linienverläufen, die unterschiedliche zeitliche Verläufe von Messwerten darstellen

Ein Beispiel für ein Prognosefenster

Oben ist der Wärmebedarf zu sehen: Zuerst 4 Tage Kontext, dann der Prognosezeitpunkt (gepunktete vertikale Linie), dann der Prognosehorizont von einem Tag (schattiert). In der Mitte steht die Außentemperatur, einmal gemessen für die Vergangenheit und einmal als Wettervorhersage, die die Modelle erhalten. Unten ist ein Kalender-Feature zu sehen, die Sinuskomponente der Tageszeit.

Allen Modellen wurden die gleichen Eingabedaten zur Verfügung gestellt: In der Regel waren dies 20 Tage historische Nachfragedaten als Kontext sowie Wetter-, Kalender- und Feiertagsinformationen für den vergangenen und den Prognosezeitraum. Wir führten drei Experimente mit realen Daten aus vier Fernwärmenetzen durch, die sich hinsichtlich ihrer Größe und ihres Verhaltens stark unterscheiden.

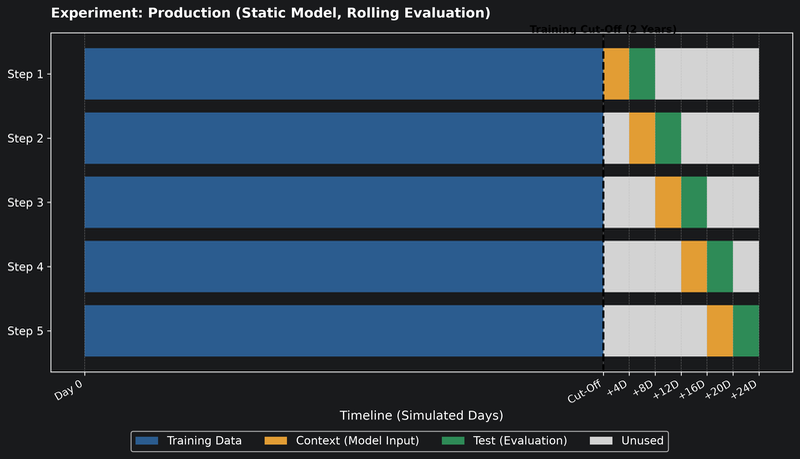
Balkendiagramm zur Produktionsvisualisierung mit fünf Schritten, das Trainingsdaten, Kontext, Testphasen und ungenutzte Zeit über simulierte Tage darstellt

Aufgabe des Produktionsexperiments (nicht maßstabsgetreu)

Die Modelle werden einmal auf mehreren Jahren Daten bis zu einem Stichtag trainiert. Wie viele Jahre es sind, hängt von der verfügbaren Historie des jeweiligen Netzes ab. Danach rückt ein Fenster schrittweise in der Zeit vor. Jeder Schritt nutzt einige Tage Kontext als Eingabe, und die folgenden Tage dienen zur Evaluation.

  • Produktion

    Ein direkter Vergleich unter realistischen Bedingungen mit 697 Prognosefenstern über alle vier Netze hinweg.

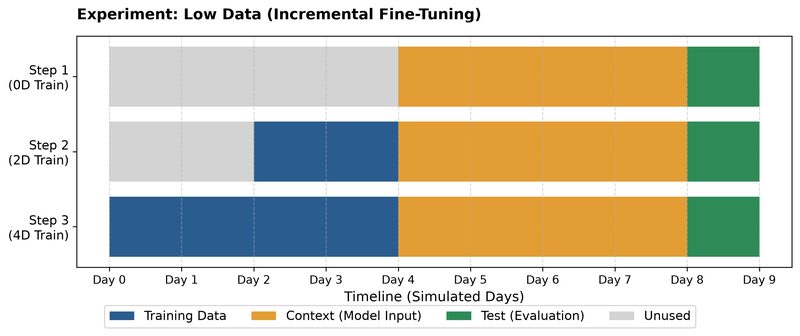
Balkendiagramm mit drei Schritten zeigt Zeitverlauf von Training, Kontext, Test und ungenutzter Zeit über neun simulierte Tage

Aufbau des Cold Start Experiments (nicht maßstabsgetreu)

Das Modell erhält immer nur wenige Tage Kontext, gefolgt von einem Evaluationsfenster. Davor wächst die Menge an Trainingsdaten schrittweise, im eigentlichen Experiment von null bis etwa 30 Tage. Damit wird eine neu angebundene Anlage simuliert.

  • Dot-2 Dot-2

    Cold Start

    Eine simulierte neue Anlage mit nur vier Tagen Kontextdaten und höchstens 30 Tagen Trainingsdaten.

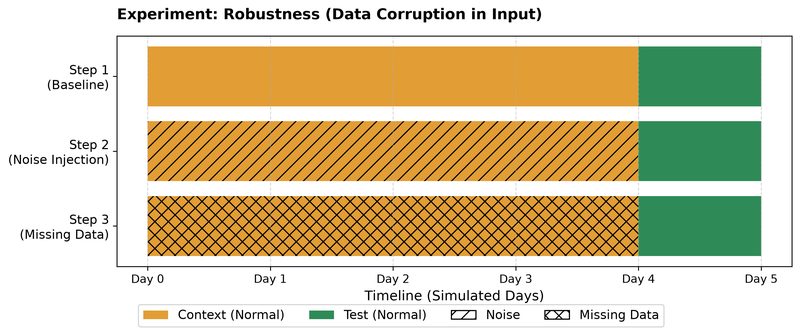
Balkendiagramm mit drei horizontalen Balken, die verschiedene Datenzustände (Normal, Rauschen, Fehlende Daten) über eine Zeitachse von Tag 0 bis Tag 5 darstellen

Aufbau des Robustheitsexperiments

Für jeden Prognosezeitpunkt werden dasselbe Kontext- und Testfenster zuerst mit unveränderten Eingabedaten genutzt (Baseline), dann mit Rauschen im Kontext und dann mit fehlenden Daten im Kontext. Beschädigt wird nur der Input-Kontext. Der Testzeitraum bleibt für jeden Prognosezeitpunkt gleich und wird nicht verändert.

  • Dot-3 Dot-3

    Robustheit

    Es wurden dieselben Prognosen erstellt, wobei die Eingabedaten absichtlich auf unterschiedliche Weise verfälscht wurden.

Die wichtigste Kennzahl ist der MAPE (Mean Absolute Percentage Error), der auch von den Betreibern im täglichen Betrieb verwendet wird. Ein MAPE von 10 % bedeutet, dass die Prognose im Durchschnitt um ein Zehntel des tatsächlichen Bedarfs abweicht. Da eine Unterschätzung hier schlimmer ist als eine Überschätzung, haben wir zusätzlich eine benutzerdefinierte Geschäftskennzahl überprüft, die Unterschätzungen doppelt so stark gewichtet, doch auch diese ergibt dasselbe Bild.

Ergebnis 1: Chronos-2 ist das genaueste Modell

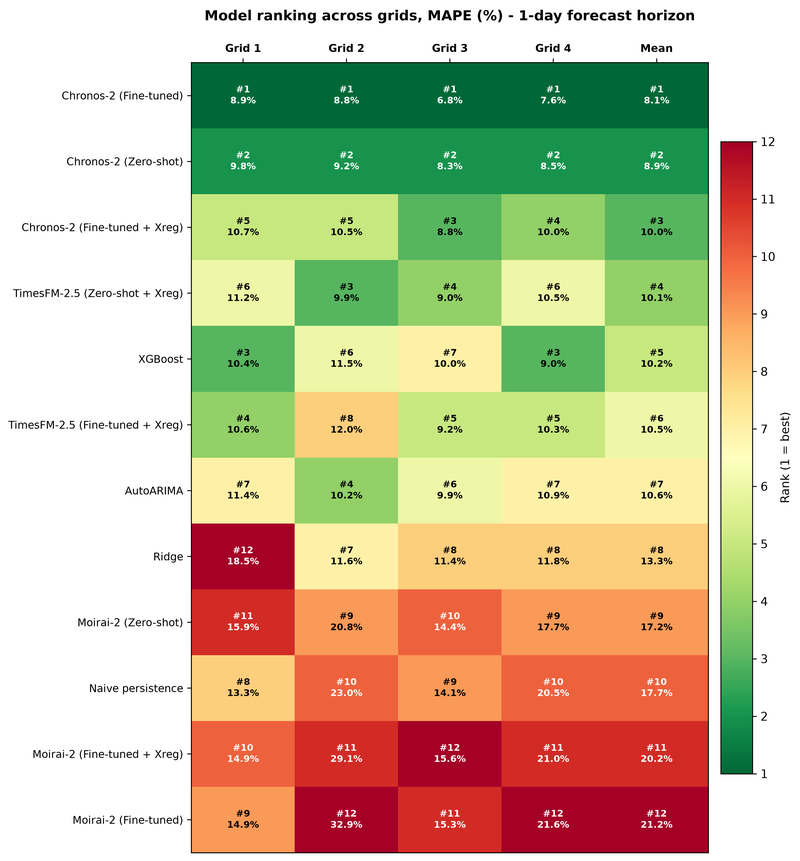
Heatmap zeigt Modell-Rankings über vier Gitter mit MAPE-Prozentwerten für 1-Tages-Vorhersagehorizont, farblich von grün (besser) bis rot (schlechter) mit Rangnummern und Mittelwerten.

Rangfolge der Modelle und ihrer Varianten je Netz und im Mittel bei einem Prognosehorizont von einem Tag

Jede Zelle zeigt den Rang und den MAPE. Die Farbe zeigt den Rang: Grün ist besser, Rot ist schlechter. Niedrigerer MAPE und niedrigerer Rang sind besser.

Chronos-2 belegt in jedem Netz die beiden ersten Plätze: Erstens nach dem Fine-Tuning und zweitens im Zero-Shot-Verfahren. Im Vergleich zu AutoARIMA liegt der MAPE-Wert bei 8,1 % statt 10,6 %, also etwa ein Viertel niedriger. Selbst ohne jegliches Training auf dem Netz liegt der Wert etwa ein Sechstel niedriger bei 8,9 %, ganz ohne Training auf dem Netz. Xreg brachte Chronos-2 keinen Vorteil, da dieses Modell die Kovariaten von sich aus besser interpretiert. TimesFM-2.5 landet zusammen mit XGBoost und AutoARIMA im engen Mittelfeld. Moirai-2 liegt am Ende auf dem Niveau der flachen Linie.

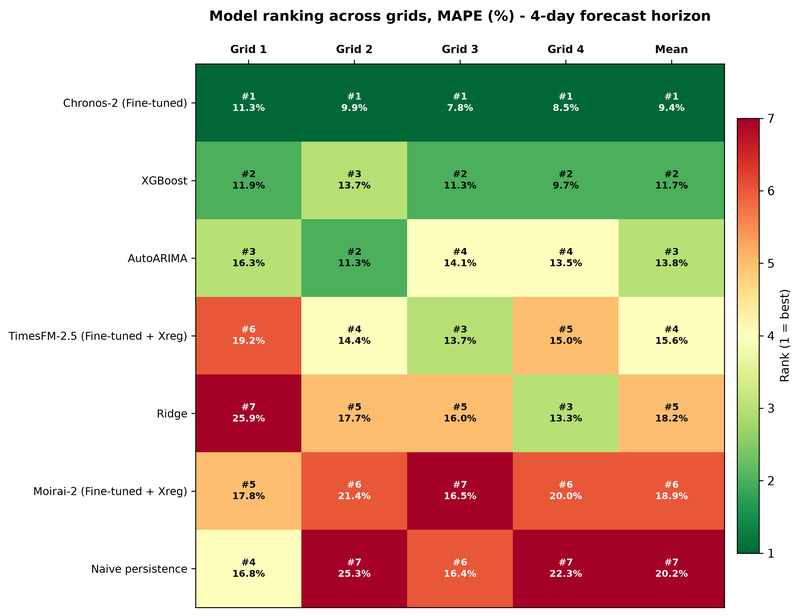
Heatmap zeigt Modell-Rankings über vier Raster mit MAPE-Werten in Prozent für eine 4-Tage-Vorhersage, grün markiert beste Ränge, rot die schlechtesten.

Dieselbe Ranking-Heatmap für den vollen Horizont von vier Tagen, mit 7 Modellvariante

Niedrigerer MAPE und niedrigerer Rang (grüner) sind besser.

Für den gesamten Zeitraum von vier Tagen haben wir einen reduzierten Datensatz verglichen, jeweils eine feinabgestimmte Konfiguration pro Basismodell. Chronos-2 bleibt mit 9,4 % statt 13,8 % MAPE vorne, was etwa einem Drittel niedriger als bei AutoARIMA ist.

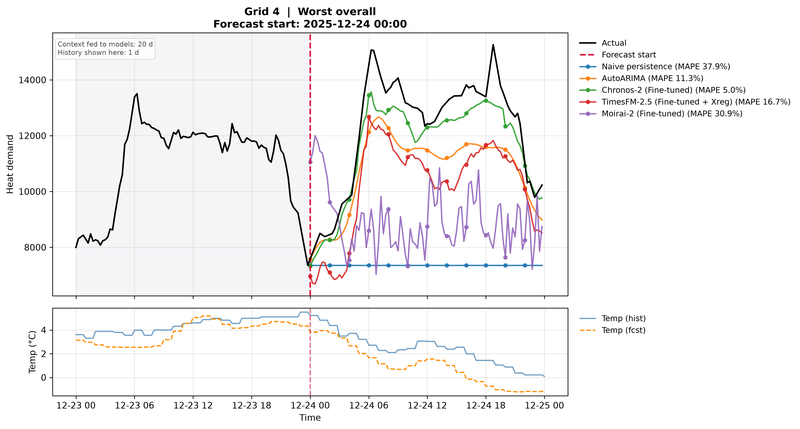
Der schwierigste Prognosetag im Testzeitraum, Heiligabend 2025 in Netz 4

Die Grafik zeigt den tatsächlichen Wärmebedarf (schwarz) und die Tagesprognosen von fünf Modellen. Der MAPE jedes Modells steht in der Legende, niedriger ist besser. Unten sind gemessene und vorhergesagte Temperatur zu sehen.

Der schlechteste Tag des gesamten Testzeitraums war Heiligabend auf einem der kleineren Netze, an dem die Nachfrage weit vom üblichen Muster abwich. Die naive Persistenz verfehlte das Ziel um fast 38 %, AutoARIMA um 11 %. Chronos-2 folgte der tatsächlichen Kurve mit einer Abweichung von lediglich 5 %.

Ergebnis 2: Es sind keine Trainingsdaten erforderlich

Zero-Shot reicht aus, um zu gewinnen. Ohne auch nur einen einzigen Tag der Historie des Zielnetzes im Training gesehen zu haben, schlägt Chronos-2 jede Baseline, einschließlich derjenigen, die genau auf dieser Historie trainiert wurden. In einem Robustheitsexperiment an einem einzelnen Netz mit weniger Testfenstern (siehe Ergebnis 3) schnitten die trainierten Baselines Ridge und XGBoost sogar schlechter ab als die flache Linie der naiven Persistenz.

Die Foundation-Models benötigen für ihre Prognosen nach wie vor Daten, nämlich den aktuellen Kontext. Was sie nicht benötigen, ist ein Trainingsdatensatz. Damit haben sie dieselben Datenanforderungen wie das heutige AutoARIMA, liefern jedoch deutlich bessere Prognosen.

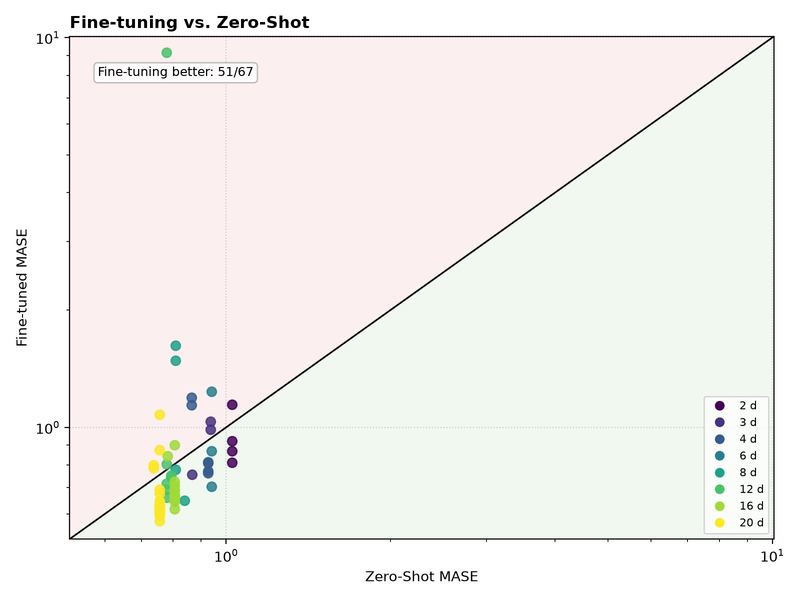
Fine-Tuning hilft, aber nur mit jahrelanger Datenhistorie.

Streudiagramm mit logarithmischer Skala zeigt Fine-tuned MASE gegen Zero-Shot MASE mit farblich markierten Punkten für verschiedene Tage von 2 bis 20 und einer Diagonalen als Referenzlinie.

Fehler von Chronos-2 zero-shot und nach Fine-Tuning im direkten Vergleich, in doppelt logarithmischer Darstellung

Jeder Punkt ist eine Konfiguration aus der Hyperparametersuche, die Farbe zeigt die Kontextlänge. Beim MASE ist niedriger besser, und Werte unter 1 schlagen eine Prognose, die einfach den Vortag wiederholt. Punkte unterhalb der Diagonale (grüner Bereich) bedeuten, dass Fine-Tuning geholfen hat: bei 51 von 67 Konfigurationen.

Bei Trainingsdaten aus nur einem Jahr verschlechterte das Fine-Tuning hingegen meist die Leistung von Chronos-2, und die besten Einstellungen waren diejenigen, die die vortrainierten Parameter am wenigsten veränderten. Bei Daten aus zwei Jahren kehrte sich das Bild um, wie oben dargestellt. Jeder Punkt steht für eine Fine-Tuning-Konfiguration aus der Hyperparametersuche im Vergleich zum Zero-Shot-Modell auf denselben Validierungsdaten. Die Farbe steht für die Kontextlänge, die dem Modell zur Verfügung stand, nicht für die Menge der Trainingsdaten. Der hier angegebene Fehler ist MASE, also der Fehler geteilt durch den Fehler einer Prognose, die einfach den Vortag wiederholt. Jeder Wert unter 1 übertrifft diese einfache Regel. 51 von 67 Konfigurationen schnitten besser ab als das Zero-Shot-Modell (Punkte unterhalb der Diagonalen); die beste Konfiguration schnitt etwa ein Viertel besser ab. Eine Konfiguration schnitt hingegen mehr als zehnmal schlechter ab: Eine Erinnerung daran, dass das Fine-Tuning auch völlig schiefgehen kann. Im Produktionsvergleich fiel der Gewinn mit 8,9 % auf 8,1 % MAPE geringer aus. Am anderen Ende des Spektrums zeigte das Cold-Start-Experiment, dass dem Modell weder 7 noch 30 Tage Trainingsdaten helfen, sich zu verbessern.

Die Dateneffizienz resultiert aus dem Vortraining und nicht aus der Anpassung an Daten aus wenigen Wochen. Dadurch kann ein neues Netz fast sofort integriert werden. Eine Feinabstimmung lohnt sich nur dort, wo bereits jahrelange saubere Historien vorliegen.

Ergebnis 3: Robust – in zweierlei Hinsicht

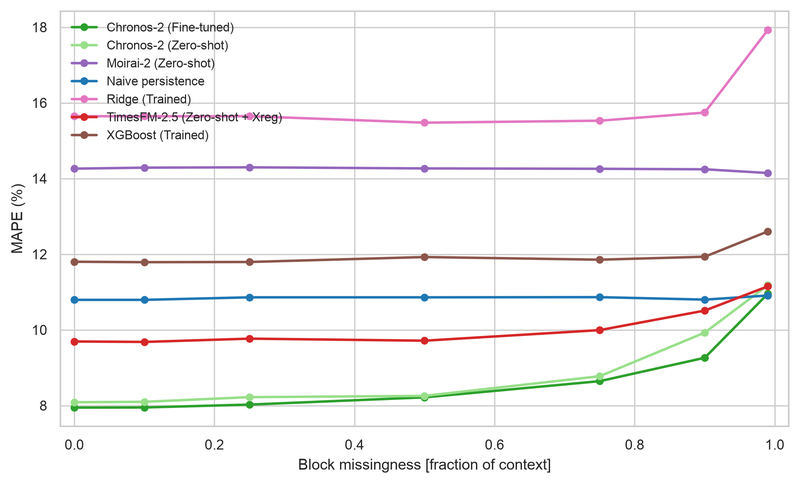
Fehlerhafte Sensordaten. Wir haben bis zu 99 % der Verbrauchsdaten entfernt, die den Modellen als Eingabe dienen. Bei den meisten Modellen hat sich der Fehler kaum verändert. Am stärksten reagierte Chronos-2: Der MAPE-Wert stieg von 8,0 % auf 11,0 %, was bei 99 % fehlenden Eingabedaten auf dem Niveau der naiven Persistenz-Baseline (10,9 %) liegt.

Liniendiagramm mit mehreren Kurven, das MAPE in Prozent gegen Blockfehlmengen als Bruchteil des Kontexts darstellt

Prognosefehler (MAPE) je Modell, wenn ein wachsender Anteil der Bedarfshistorie blockweise entfernt wird, von 0 bis 99 %

Niedriger ist besser. Je flacher die Linie, desto robuster ist das Modell gegenüber fehlenden Daten.

Der Grund dafür sind die unverändert gelassenen Wetterdaten: Sie enthalten so viel vom Signal, dass die Modelle den Großteil des Tagesprofils daraus rekonstruieren können. Dies spiegelt einen realistischen Ausfall wider, beispielsweise wenn ein Wärmezähler ausfällt, während der Wetterdienst weiterläuft, führt aber auch zu einem optimistischen Ergebnis. Interessanterweise reagierte Chronos-2 am empfindlichsten auf beschädigte Eingabedaten, da es aus intakten Eingabedaten das Beste herausholt. Dennoch gehörte es bei jeder Art von Datenverlust, einschließlich zufälligem Rauschen, zu den besten Modellen. In der Grafik fehlt AutoARIMA: Da es CPU-gebunden ist und für jede Prognose neu angepasst wird, verursacht es einen erheblichen Rechenengpass. In einem separaten, kleineren Durchlauf lag Chronos-2 bei jedem Ausmaß an Datenverlusten vor AutoARIMA oder auf gleicher Höhe.

Betriebssicherheit im Einsatz. Ein guter Durchschnittswert ist nutzlos, wenn ein Modell an den meisten Tagen hervorragende Ergebnisse liefert, an einigen wenigen Tagen jedoch katastrophal versagt. Schließlich muss jeden Tag eine Planung erfolgen.

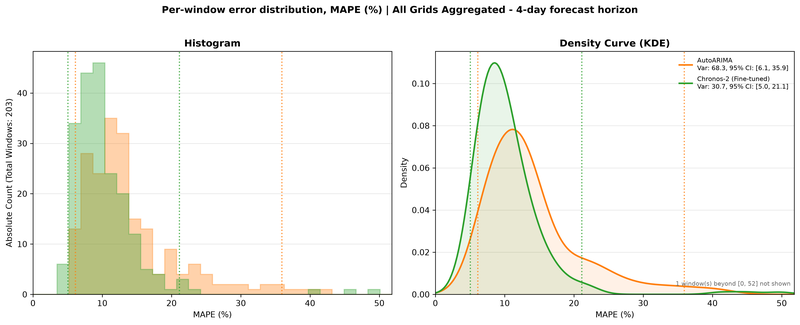
Zweigeteilte Grafik mit Histogramm links und Dichtekurve rechts, die Fehlerverteilung (MAPE in Prozent) für 4-Tage-Vorhersagen verschiedener Modelle zeigt.

Verteilung des MAPE über alle Vier-Tages-Prognosen aller Netze (203 Fenster) für Chronos-2 (mit Fine-Tuning) und AutoARIMA

Links als Histogramm, rechts als Dichtekurve. Gepunktete Linien markieren das 95-%-Intervall (2,5. bis 97,5. Perzentil). Besser ist eine Verteilung, die weiter links liegt (geringerer Fehler) und schmaler ist (geringere Streuung, weniger sehr schlechte Tage).

Die Grafik zeigt den MAPE jeder Vier-Tage-Prognose über alle Netze hinweg. Die Fehler von Chronos-2 liegen viel enger beieinander als die von AutoARIMA. Außerdem gibt es weitaus weniger sehr schlechte Tage: 97,5 % seiner Prognosen bleiben unter 21 %, bei AutoARIMA sind es nur 36 %. Außerdem war Chronos-2 über die vier Netze hinweg am konsistentesten.

Laufzeit. AutoARIMA passt sich bei jeder Vorhersage neu an, was jeweils etwa eine Minute dauert. In seltenen Fällen kann es nicht konvergieren. Die Foundation Models erzeugen eine Vorhersage auf einer GPU in einem Bruchteil dieser Zeit, ohne dass eine Neuanpassung erforderlich ist.

Was wir daraus lernen

  • Die Behauptung, es handele sich um universelle Prognosemodelle, ist keine Garantie. Sie traf auf Chronos-2 zu, teilweise auf TimesFM-2.5, aber nicht auf Moirai-2.

  • Neue Fernwärmenetze können ohne Trainingsdaten integriert werden und liefern deutlich bessere Prognosen als das derzeit verwendete Modell.

  • Ein Fine-Tuning lohnt sich erst bei einer Datenhistorie von zwei oder mehr Jahren. Bei einer kürzeren Historie sollte das Modell unverändert verwendet werden.

  • Nächster Schritt: Schattenbetrieb. Chronos-2 sollte parallel zu den Produktionsmodellen mit Live-Daten betrieben werden, wobei AutoARIMA als bewährte Ausweichlösung dient. Eine Offline-Studie liefert Anhaltspunkte, ist jedoch kein endgültiger Beweis.

Es gelten einige Einschränkungen: Robustheit, Hyperparameter-Optimierung und Cold Start wurden nur an einem Netz getestet. Die Wetterdaten waren stets fehlerfrei. Die Branche entwickelt sich rasant weiter. Während der Studie erhielten alle drei Modelle umfangreiche Updates.

Unsere Auswirkungen

BeOpt ist ein etabliertes Produktionssystem von Iqony Energies, das die Verarbeitung von Sensordaten, die Prognoseerstellung und die Einsatzoptimierung für eine heterogene Gruppe von Fernwärmenetzen abdeckt. Für diese Studie lieferte die bestehende Plattform die bereinigten Daten. Alles andere – von der Vorverarbeitung und Modellintegration bis hin zum Experimentierrahmen, der Auswertung und jeder Abbildung in diesem Beitrag – wurde eigens für diesen Zweck entwickelt und kann nun Fragen beantworten, die weit über die hier gestellten hinausgehen.

Wenn Sie sich mit Prognosen in Energiesystemen beschäftigen oder sich fragen, ob es sich lohnt, Foundation Models an Ihren eigenen Zeitreihen zu testen, melden Sie sich gerne bei uns.

Dieser Artikel basiert auf der Masterarbeit „Transfer Learning für heterogene Fernwärmenetze: Evaluation der Dateneffizienz und Robustheit von Time Series Foundation Models“, die bei scieneers GmbH in Zusammenarbeit mit der Hochschule Karlsruhe verfasst wurde.

Autor

Severin Hotz, Data Scientist bei scieneers GmbH
severin.hotz@scieneers.de

© Copyright scieneers – Impressum | Datenschutz
Nach oben scrollen Nach oben scrollen Nach oben scrollen