Bei der Planung von Datenprodukten oder Softwareprojekten entsteht oft erst durch eine klare Abgrenzung der Entwicklungsphasen Klarheit.
Ein stufenweiser Aufbau reduziert die Unsicherheit schrittweise und gleicht die Erwartungen in interdisziplinären Teams an.
https://www.scieneers.de/wp-content/uploads/2026/02/PoC-vs-Prototyp-vs-MVP-vs-Pilot.png13752385shinchit.han@scieneers.dehttps://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.pngshinchit.han@scieneers.de2026-02-06 13:50:342026-02-27 16:20:32PoC vs Prototyp vs MVP vs Pilot
Die Bilder mit variabler Fingeranzahl und verzerrten Gesichtern, die von KI-Bildgeneratoren noch vor wenigen Jahren erzeugt wurden, sind uns allen noch in guter Erinnerung. Die meisten Ergebnisse waren bestenfalls lustig, für eine echte Verwendung aber eher unbrauchbar. Das hat sich – vor allem in 2025 – drastisch geändert. Die Grenzen des technisch Machbaren und damit auch die Zahl möglicher Use Cases verschieben sich monatlich. Die Bildgenerierung wird immer schneller und günstiger. Zudem kann sie sich auf mehr Referenzbilder beziehen und Texte besser darstellen. Dabei sind auch 4K-Auflösungen und sämtliche gängigen Bildformate kein Problem mehr. Die Vorreiter dieser Revolution sind der Software-Gigant Google und ein vergleichsweise kleines, aber schlagkräftiges Startup aus Freiburg. Doch dazu später mehr.
Gemeinsam mit unserem Kunden haben wir ein umfangreiches Projekt mit Bildgenerierung als grundlegender Technologie realisiert: eine Anwendung zur KI-unterstützten Erstellung von sogenannten Storyboards – verbildlichte Darstellungen von Stories. In diesem Blogbeitrag teilen wir unsere Erfahrungen aus diesem Projekt. Darüber hinaus gehen wir auf die Funktionsweise der aktuell besten Modelle ein, geben einen Überblick über die aktuelle Modelllandschaft, erklären, wie man Bildmodelle effektiv promptet, und stellen weitere mögliche Use Cases vor.
Gängige State-of-the-Art (SOTA) Bildgeneratoren basieren unter der Haube auf einer Kombination aus der Transformer-Architektur, die auch großen Sprachmodellen zugrunde liegt, und sogenannten Diffusionsmodellen. Diffusionsmodelle erzeugen aus zufälligem Pixelrauschen (wie es früher bei schlechtem Empfang auf dem Fernseher zu sehen war) hochauflösende Bilder. Grob kann man sich die Vorgehensweise wie eine Art Kamera vorstellen, nennen wir sie für das Beispiel “Traumkamera”:
Wie eine echte Kamera startet die Traumkamera mit einer geschlossenen Linse. Dadurch fällt kein Licht-Signal auf die einzelnen Pixelsensoren, dort entsteht nur ein komplett zufälliges Signal aus thermischem Rauschen.
Anstatt die Linse zu öffnen, erhält die Traumkamera als Signal jetzt ein Prompt, der beschreibt, welches Bild generiert werden soll. Die innere Elektronik der Traumkamera wurde durch ein Training mit sehr vielen Prompts und fertigen Bildern so verschaltet, dass sie das zufällige Rauschen schrittweise in ein echtes Bild umformt. In jedem Schritt werden die einzelnen Pixel-Intensitäten und -Farben so angepasst, dass nach und nach das gewünschte Bild entsteht – wie bei einer echten Kamera, bei der während der Belichtungszeit immer mehr Licht auf die Sensoren fällt und so das fertige Bild entsteht. Das faszinierende an der Traumkamera: ihre Linse wurde nie geöffnet, das Bild entstand einzig aus dem Prompt und dem Trainingsdatensatz, der implizit die Schaltkreise der Traumkamera geformt hat.
Eine wichtige Verbesserung der ersten Diffusionsmodelle ist das sogenannte Flow-Matching. Diese Methode ermöglicht in deutlich weniger Schritten zum fertigen Bild zu gelangen, was die Erstellung eines Bildes erheblich beschleunigt.
Ein großer Nachteil von Diffusionsmodellen ist, dass sie zwar hochauflösende Bilder generieren können, aber kein gutes Textverständnis besitzen. Um dieses Problem zu beheben, hat man die Innovation im Bereich der großen Sprachmodelle genutzt. So entstanden Modelle, die komplexe Eingaben verstehen und scharfe Bilder generieren können. Und das alles in einem Schritt und mit natürlicher Sprache.
Modelllandschaft
Geht man nur nach der Leistungsfähigkeit, ist das Rennen an der Spitze mittlerweile wieder offen. Neben Gemini 3 Pro Image (Nano Banana Pro) und Flux 2 zählt nun auch GPT Image 1.5 von OpenAI wieder zu den besten Bildgeneratoren. Während Black Forest Labs (das Freiburger Startup) mit Flux 2 Dev zudem eine starke Open-Weights-Variante anbietet, punkten abseits der Platzhirsche auch chinesische Modelle wie Seedream 4.0 oder Qwen Image Edit. OpenAI profitiert somit nicht mehr nur von seiner weiten Verbreitung, sondern kann leistungstechnisch endlich wieder überzeugen. Der Zeitverlauf verdeutlicht die große Dynamik in der Modellentwicklung: Nach dem Hype um GPT-Image-1 im April (man erinnere sich an die Ghibli-Welle) und einer zwischenzeitlichen Durststrecke hat OpenAI mit dem aktuellen Update nun technologisch wieder aufgeschlossen.
Prompting
Wer schon einmal versucht hat, mithilfe von KI ein exaktes Bild zu erstellen, kennt das Problem: Das Ergebnis ist oft zufällig. Für eine professionelle Nutzung ist daher strukturiertes Prompting erforderlich.
Die Grundstruktur ist dabei relativ einfach: Je zentraler ein Element für das Bild ist, desto eher wird es im Prompt genannt und desto höher ist auch der Detailgrad seiner Beschreibung. Weniger zentrale Elemente wie der Bildhintergrund werden dagegen erst am Ende des Prompts mit weniger Details beschrieben.
Um den Blickwinkel und die Distanz eines Bildes zu spezifizieren, gibt es verschiedene Begriffe aus der professionellen Fotografie und der Filmbranche:
Neben der Perspektive ist bei Bildern vor allem die Belichtung entscheidend. Schon eine kleine Veränderung im Prompt kann das gesamte Bild anders wirken lassen. Bei den folgenden drei Bildern variieren wir jeweils nur die Belichtung.
…large floor-to-ceiling windows overlooking a dense metropolitan street filled with electric vehicles and glass skyscrapers. Cinematic lighting, sharp focus on the hologram, shallow depth of field, 8k resolution.
Erstes Bild + „transform the lighting into twilight lighting„
Erstes Bild + „transform the lighting into neon lighting„
Das sogenannte Color Grading ist eng mit dem Lighting verbunden. Die Kunst besteht darin, die Farben so auszuwählen, dass der gewünschte visuelle Stil getroffen wird. So kann dem Bild ein spezifisches „Look and Feel“ verliehen werden. Um den Unterschied zu verdeutlichen, haben wir erneut die Farben eines Promptes variiert. Dabei müssen wir auch die Tageszeit ändern, da sie sonst nicht zu den Farben passt. Bei dem Color Grading lohnt sich in der Regel eine etwas ausführlichere Beschreibung der Farben:
A young woman standing in a field of wheat at dusk, cool blue twilight atmosphere, desaturated teal and slate gray tones, pale silver sky, cold and melancholic mood, cinematic.
A young woman standing in a field of wheat at sunset, bathed in warm golden hour light, rich amber and honey tones throughout, deep orange sky, everything glowing with warmth, cinematic.
Auch bestimmte Kameraeinstellungen eignen sich sehr gut als Steuerungsbegriffe. Mit dem Keyword „Depth of Field“ kann beispielsweise festgelegt werden, wie tief der Fokus der Kamera gehen soll. Selbst die Brennweite des Kameraobjektivs kann man im Prompt mitgeben, um bestimmte Perspektiven und Fokusverhalten zu erreichen.
Shallow depth of field
Deep depth of field
200mm telephoto lens
Ultra-wide 14mm lens
Neben diesen speziellen Einstellungen kann man beim Prompting mittlerweile auf spezielle Sprache verzichten und einfach natürliche Sprache verwenden, so wie man auch große Sprachmodelle promptet. Dabei muss man beachten, dass nur ein gewisser Detailgrad von Bildmodellen abgedeckt werden kann. Außerdem müssen die einzelnen Teile des Bildprompts zueinander passen. Das wird vor allem dann zum Problem, wenn man seine Prompts zur Bildgenerierung von LLMs generieren lässt. Diese können Anweisungen generieren, die für das Bildmodell geometrisch gar nicht darstellbar sind. Oft kommt dann ein fehlerhaftes oder zusammengewürfeltes Ergebnis heraus.
A woman standing in the far left corner of a minimalist white gallery … her hand casually resting on a coffee cup placed on a small wooden table in the far right corner.
Außerdem funktionieren manche Keywords besser als andere: So ist beispielsweise eine Anpassung der Belichtung für viele Modelle einfacher als das exakte Darstellen einer Kameraperspektive.
Bildgenerierung im Einsatz bei der Erstellung visueller Storyboards
Im Anwendungsfall, bei dem eine bestehende, kurze Story in ein visuelles Storyboard überführt werden soll, kommen zu den oben genannten Prompting-Techniken weitere Aspekte des Context-Engineerings hinzu. Um eine Geschichte in einer Serie von mehreren Szenenbildern visuell erzählen zu können, braucht es neben hochqualitativen Einzelbildern vor allem Konsistenz über mehrere Bilder hinweg. Bei einer realen Fotoserie ist es natürlich, dass die Charaktere alle gleich aussehen und auch im Hintergrund die gleichen Gegenstände oder Örtlichkeiten absolut realistisch dargestellt sind. Für KI-generierte Bilder ist dies hingegen eine Herausforderung: Jedes einzelne Bild der Serie wird neu generiert, und der inhärent probabilistische Prozess sorgt dafür, dass jedes Bild zunächst einmal anders aussieht.
Solche Schwierigkeiten können mithilfe eines wichtigen Features der aktuellsten KI-Bildmodelle umgangen werden. Nicht nur textuelle Prompts, sondern auch Referenzbilder sind als Input möglich, und die erzeugten Bilder können viele visuelle Details der Referenzbilder wiedergeben. Zuverlässig funktioniert dies zum aktuellen Zeitpunkt für etwa 5–10 Bilder, je nach Anwendungsfall. Damit können zumindest zentrale Charaktere und Objekte einer kurzen Story immer auch als Referenz bei der Generierung einzelner Szenen verwendet werden.
Für unseren Anwendungsfall haben wir eine dedizierte Orchestrierung verschiedener LLM- und Bildmodell-Aufrufe genau darauf zugeschnitten. Zunächst werden detaillierte Bildgenerierungs-Prompts für die Hauptcharaktere einer Story mithilfe eines Reasoning-Modells – eines für komplexe Aufgaben optimierten Sprachmodells – extrahiert. Basierend auf diesen Prompts wird für jeden Charakter ein Bild erzeugt, das als zentrale Referenz für alle Szenen dient, in denen der Charakter vorkommt. Weiter generieren wir detaillierte Prompts für jede einzelne Szene des Storyboards, wobei wir die oben beschriebenen Techniken umsetzen. Zusätzlich erzeugen wir Konsistenz zwischen den Beschreibungen auf textueller Ebene, was die darauffolgenden Bilder deutlich harmonischer wirken lässt. In der von uns entwickelten Oberfläche können Nutzende jeden einzelnen Schritt überwachen und an einzelnen Prompts oder Bildern feilen. Dadurch lassen sich kleinere Fehler oder Inkonsistenzen in den Bildern schnell korrigieren.
Ein abgewandeltes Beispiel ist die folgende Geschichte, in welcher der kleine Ben den Weihnachtsmann über zeitgemäße Transportmittel belehrt:
Eingesetzte Technologien
Die Anwendung ist modular aufgebaut und bewusst anbieterunabhängig: Alle Aufrufe an Reasoning-Modelle laufen über LangChain, was einen schnellen Modellaustausch ermöglicht. Bei den Bildmodellen setzen wir auf native APIs der Modellanbieter. Unsere Erfahrung hat gezeigt, dass sich die Schnittstellen zurzeit noch schneller ändern, als Libraries wie LangChain nachziehen können. Dies führt zu unnötigen Reibungen bei der Anbindung.
Für Debugging und Qualitätsverbesserung werden sämtliche Generierungen vollständig getraced – vom Storyline-Parsing über die Prompt-Optimierung bis zum fertigen Bild. So lässt sich bei unerwarteten Ergebnissen exakt nachvollziehen, welche Prompts und Referenzen verwendet wurden.
Generierte Bilder werden versioniert in einem Cloud-Storage abgelegt; Referenzen zwischen Cast- und Szenenbildern bleiben erhalten. Nutzende können eigene Bilder hochladen, die dann wie generierte Assets behandelt werden – inklusive der Verwendung als Referenz für nachfolgende Generierungen.
Limitationen
Moderne KI-Bildmodelle bringen ein enormes technologisches Potenzial. Trotzdem zeigen sich beim produktiven Einsatz in unserem Anwendungsfall deutliche Grenzen und Schwierigkeiten.
Konsistenz bleibt das Kernproblem:Komplexere Perspektivwechsel– etwa wenn ein Charakter in einer Szene von vorne und in der nächsten von der Seite zu sehen ist – bringen aktuelle Modelle an ihre Grenzen. Hintergründe lassen sich durch Referenzbilder nur schwer übertragen. Gleichbleibende Räumlichkeiten über einige wenige Szenen lassen sich noch durch starke Konsistenz-Mechanismen in unserem Workflow erzielen. Je länger die gewünschte Sequenz allerdings wird, desto eher erzeugen die Bildmodelle auffallende Artefakte.
Nicht jeder Use Case eignet sich: Das System funktioniert gut, wenn keine realen Persönlichkeiten dargestellt werden müssen und die visuellen Zusammenhänge überschaubar bleiben.
Ausblick
Gemeinsam mit den Nutzenden entwickeln wir weitere Workflows – und arbeiten daran, das bestehende System agentenbasierter zu gestalten: Es soll selbstständig auf Feedback reagieren und Bilder iterativ verbessern können. So testen wir „LLM-as-a-judge“-Ansätze, bei denen das Bildverständnis multimodaler Sprachmodelle genutzt wird, um Artefakte und Inkonsistenzen automatisch festzustellen.
Ein weiterer spannender Schritt, auch für unseren Anwendungsfall, ist die KI-basierte Videogenerierung. Auch bei Videomodellen verschieben sich die Grenzen des Machbaren rasant. Aktuelle Modelle kämpfen noch mit den typischen Schwierigkeiten der Bildgenerierung – nur verstärkt, denn Bewegtbild erfordert eine noch stringentere Konsistenz über viele Frames hinweg. Wir evaluieren kontinuierlich die neuesten Modelle und sind optimistisch, dass eine automatisierte Videogenerierung schon bald realisierbar wird.
Darüber hinaus bieten die Bildmodelle weitere interessante Anwendungsfälle: die automatisierte Erstellung von Infografiken und Schaubildern mit konsistenten Illustrationen, die Produktvisualisierung im E-Commerce – etwa um Möbel in verschiedenen Wohnstilen oder Kleidung in unterschiedlichen Settings darzustellen – oder die Generierung von konsistentem Social-Media-Content, der eine einheitliche Markenästhetik über viele Posts hinweg sicherstellt.
https://www.scieneers.de/wp-content/uploads/2026/02/generation-0b7e1601-bb5a-46a3-8ec2-c8fbc34c2c85.png7521328mats.faulborn@scieneers.dehttps://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.pngmats.faulborn@scieneers.de2026-02-05 15:08:342026-03-31 09:12:20KI-Bildgenerierung in der Praxis
Data Science, KI und Cloud-Architekturen sind unser tägliches Geschäft – doch manchmal lohnt es sich, die eigene Blase zu verlassen. Genau das taten unsere scieneers-Kolleg:innen Mitte Dezember auf den IT-Tagen 2025 in Frankfurt. Zwischen den Themen Softwarearchitektur, DevOps, agilen Methoden und digitaler Souveränität haben wir Impulse mitgenommen, die direkt in unsere tägliche Arbeit rund um skalierbare RAG-Systeme, saubere Softwarearchitektur und Monitoring einfließen werden.
Large Language Models (LLMs) sind leistungsfähig, arbeiten jedoch ohne Echtzeitzugriff auf Ihre Daten. Sie haben Schwierigkeiten mit privaten, sich ändernden oder domänenspezifischen Informationen und neigen zu Halluzinationen, wenn ihre Trainingsdaten unvollständig sind. Retrieval-Augmented Generation (RAG) begegnet diesem Problem, indem zur Anfragezeit relevanter Kontext aus eine externen Datenquellen abgerufen und dem Modell zur Verfügung gestellt wird.
Um eine schnelle und kontextbewusste Retrieval-Funktion auf Basis einer Nutzeranfrage zu ermöglichen, setzen die meisten Systeme auf semantische Suche über Embeddings. Dabei werden Dokumente in kleinere Chunks aufgeteilt, in einen hochdimensionalen Vektorraum eingebettet und dasselbe mit der Nutzeranfrage durchgeführt. Eine Ähnlichkeitssuche identifiziert anschließend die nächstgelegenen Treffer. Semantische Suche allein weist jedoch Lücken auf: Seltene Begriffe, exakte Phrasen oder Code-Snippets lassen sich häufig besser über keywordbasierte Suche abdecken. Aus diesem Grund nutzen viele produktive Setups einen hybriden Ansatz, der beide Methoden kombiniert
Eine gängige Wahl sind gemanagte Vektor-Datenbanken wie Pinecone, Weaviate oder Chroma. Diese funktionieren gut, bringen jedoch zusätzlichen operativen Aufwand mit sich: mehr Infrastruktur, mehr APIs, die verwaltet werden müssen, und höhere Kosten. Für viele Projekte gibt es eine einfachere Alternative: PostgreSQL kann in Kombination mit der pgvector-Erweiterung als Vector Store dienen und semantische Suche direkt unterstützen – während gleichzeitig keywordbasierte Suche über die integrierten Full-Text-Search-(FTS)-Funktionen möglich ist. Da PostgreSQL in vielen Backends ohnehin die primäre Datenbank ist, bietet dieser Ansatz eine komfortable Möglichkeit, alles an einem Ort zu halten und dennoch hybride Suche effizient umzusetzen.
Dieser Beitrag ist ein praxisorientierter Leitfaden und deckt folgende drei Bereiche ab:
Am Ende verfügen Sie über ein funktionierendes, auf PostgreSQL basierendes Retrieval-Setup, das ein RAG-System unterstützen kann, ohne eine weitere Infrastrukturkomponente hinzufügen zu müssen.
pgvector erweitert PostgreSQL um native Vektortypen und Nearest-Neighbor-Suche, sodass Embeddings direkt neben relationalen Daten gespeichert und mit SQL abgefragt werden können. Um pgvector zu verwenden, muss die Erweiterung einmal pro Datenbank aktiviert werden:
CREATE EXTENSION IF NOT EXISTS vector;
pgvector unterstützt mehrere Vektortypen mit unterschiedlichen Limits:
VECTOR – bis zu 2.000 Dimensionen
HALFVEC – bis zu 4.000 Dimensionen
BIT – bis zu 64.000 Dimensionen
SPARSEVEC – bis zu 1.000 Nicht-Null-Elemente
Für Embedding-Modelle mit einer Dimensionalität unter 2k (z. B. OpenAI text-embedding-3-small) ist VECTOR die Standardwahl. Für Modelle, die über 2k Dimensionen hinausgehen (z. B. OpenAI text-embedding-3-large), ist HALFVEC eine naheliegende Option, da es den Speicherbedarf ungefähr halbiert.
Einrichten einer VECTOR-Spalte für Embeddings
Für jede Tabelle können eine oder mehrere Vektorspalten hinzugefügt werden. Wenn die Dimensionalität der Embeddings bekannt ist, sollte sie explizit angegeben werden, da dies frühe Prüfungen und eine bessere Query-Planung ermöglicht. Zum Beispiel:
CREATE TABLE documents (
id
titel
        BI GSERIAL PRIMÄRSCHLÜSSEL,
     TEXT,
Inhalt TEXT,
einbettung VECTOR(1536)
);
PostgreSQL erstellt Embeddings nicht selbst. Diese müssen mit einem Embedding-Modell berechnet und anschließend zusammen mit den bestehenden Daten in der Datenbank gespeichert werden.
Ausführen einer Vektorsuche
Beim Abfragen der Datenbank wird zunächst ein Embedding für die Anfrage berechnet – mit demselben Modell, das auch beim Speichern der Dokument-Embeddings verwendet wurde. Dadurch kann der Anfragevektor mit den Vektoren in der Datenbank verglichen werden, um die relevantesten Treffer zu ermitteln.
Um zu messen, wie nah zwei Vektoren in diesem Raum beieinanderliegen, werden üblicherweise verschiedene Ähnlichkeitsmetriken verwendet:
L2-Distanz: <->
Inneres Produkt (negativ, für aufsteigende Sortierung): <#>
Cosine Distanz: <=>
L1-Abstand: <+>
Bit-Vektoren: Hamming <~> und Jaccard <%>
Die Cosine Distanz ist eine gute Standardwahl, da sie die Ähnlichkeit der Richtung und nicht die reine Magnitude misst. Die meisten Embedding-Modelle erzeugen Vektoren, bei denen die Richtung die Bedeutung kodiert, und viele Anbieter normalisieren die Vektoren auf Einheitslänge. Unter Normalisierung liefern Cosine Distanz, Inneres Produkt und L2-Distanz identische Rankings, wobei Cosine Distance und Inneres Produkt in der Regel schneller zu berechnen sind und weniger empfindlich auf Unterschiede in der Vektorskala reagieren.
Beispielabfrage:
SELECT id, title
FROM dokumente
ORDER BY embedding <=> $1 -- $1 ist ein 1536-dim Vektorliteral wie '[...]'
LIMIT 10;
Indexierung für Performance
Exakte Vektorsuche bietet perfekte Recall-Werte, skaliert jedoch schlecht. Bei großen Datensätzen steigt die Latenz, da jeder Vektor vollständig gescannt werden muss. Um die Latenz zu reduzieren, wird ein Approximate-Nearest-Neighbor-(ANN)-Index hinzugefügt. pgvector unterstützt zwei ANN-Indextypen: IVFFlat (inverted file with flat compression) und HNSW (hierarchical navigable small world).
IVFFlat partitioniert den Vektorraum in Cluster (sogenannte Lists). Zur Query-Zeit werden nur die ähnlichsten Lists durchsucht. Der Index lässt sich schnell aufbauen und benötigt vergleichsweise wenig Speicher, erreicht jedoch einen geringeren Recall als HNSW. Der Index sollte nach dem Laden repräsentativer Daten erstellt werden. Die Anzahl der Lists wird beim Erstellen des Indexes festgelegt, und über ivfflat.probes – das steuert, wie viele dieser Cluster pro Anfrage durchsucht werden – kann pro Query ein Kompromiss zwischen Recall und Geschwindigkeit eingestellt werden.
CREATE INDEX ON documents
USING ivfflat (embedding halfvec_cosine_ops) WITH (lists = 100); -- per-query recall/speed trade-off
SET ivfflat.probes = 10;
Faustregeln: Beginnen Sie mit lists = rows / 1000 bis zu 1 Mio. Zeilen und mit sqrt(rows) darüber hinaus; setzen Sie probes ≈ sqrt(lists).
HNSW erstellt eine mehrschichtige Graphstruktur, in der jeder Vektor mit mehreren Nachbarn verbunden ist. Anfragen navigieren von groben oberen Ebenen zu detaillierteren unteren Ebenen, was schnelle Lookups bei gleichzeitig hohem Recall ermöglicht. HNSW eignet sich besonders für leseintensive Workloads, benötigt jedoch mehr Speicher und längere Build-Zeiten als IVFFlat. Ein separater Trainingsschritt ist nicht erforderlich.
Die Qualität des Indexes und der Ressourcenverbrauch werden über zwei Parameter zur Build-Zeit gesteuert
m: Anzahl der Verbindungen, die jeder Knoten hält. Höhere Werte verbessern den Recall, erhöhen jedoch den Speicherbedarf.
ef_construction: Wie breit während des Builds nach Nachbarn gesucht wird. Höhere Werte verbessern die Graphqualität, verlangsamen jedoch die Indexerstellung.
Zur Abfragezeit werden folgender Parameter angepasst:
hnsw.ef_search: Anzahl der Kandidaten-Nachbarn, die untersucht werden. Höhere Werte erhöhen den Recall, verlangsamen jedoch die Abfrage.
CREATE INDEX ON documents
USING hnsw (embedding halfvec_cosine_ops)
WITH (m = 16, ef_construction = 64);
Welche Option ist die richtige? Verwenden Sie HNSW, wenn Sie den bestmöglichen Recall und die geringste Latenz erzielen möchten und ausreichend Speicher zur Verfügung steht. Verwenden Sie IVFFlat, wenn schnellere Build-Zeiten oder ein geringerer Speicherverbrauch wichtiger sind. Bei beiden Indextypen sollten Sie in Ihren Queries stets ORDER BY … LIMIT verwenden, damit der Query Planner den Index nutzen kann.
Nachdem die Vektorsuche eingerichtet ist, kann die keywordbasierte Retrieval-Funktionalität mithilfe der nativen Full Text Search (FTS) von PostgreSQL ergänzt werden. FTS eignet sich besonders gut für exakte Begriffe, seltene Wörter oder Code-Snippets und ist damit eine sinnvolle Ergänzung zu Embeddings in einem hybriden Such-Setup.
Einrichten einer TSVECTOR-Spalte für durchsuchbaren Text
PostgreSQL speichert durchsuchbaren Text in einem TSVECTOR, der normalisierte Lexeme sowie optional Positionsinformationen enthält. Zum Beispiel:
„Lernen Sie die Verwendung von tsvector und tsquery“ → ‚lernen‘:1 ‚verwenden‘:4 ‚tsvector‘:5 ‚tsquery‘:7
Die Funktionen zum Erzeugen und Abfragen dieser Vektoren sind bereits integriert. Um eine Neuberechnung bei jeder Anfrage zu vermeiden, sollte der TSVECTOR vorab berechnet und in der Tabelle gespeichert werden. Eine generierte, gespeicherte Spalte hält ihn dabei automatisch synchron.
Das obige Beispiel verwendet die Text-Search-Konfiguration simple (keine Stemming- oder Stopword-Entfernung), um den TSVECTOR zu erzeugen. PostgreSQL bietet außerdem sprachspezifische Analyzer (z. B. english, german usw.), die Stemming und Stopword-Removal für die jeweilige Sprache durchführen.
Um alle unterstützten Sprachen aufzulisten, führen Sie Folgendes aus:
SELECT cfgname FROM pg_ts_config;
Für mehrsprachige Daten kann zusätzlich eine sprachspezifische Spalte pro Zeile gespeichert werden, und to_tsvector(ts_config, text) kann entsprechend dynamisch aufgerufen werden.
Gewichtung
PostgreSQL unterstützt außerdem die unterschiedliche Gewichtung von Feldern (z. B. Titel > Textkörper) über gewichtete Vektoren:
ALTER TABLE films
ADD COLUMN search_vector tsvector
GENERATED ALWAYS AS (
setweight(to_tsvector('english', title), 'A') ||
setweight(to_tsvector('english', description), 'B')
) STORED;
Das von PostgreSQL standardmäßig verwendete Gewichtungs-Array ist {D=0.1, C=0.2, B=0.4, A=1.0}, kann jedoch zur Query-Zeit angepasst werden.
Indexierung
PostgreSQL unterstützt zwei Indextypen für Full Text Search: GIN (Generalized Inverted Index) und GiST (Generalized Search Tree).
GIN speichert einen echten invertierten Index: Für jedes Lexem wird eine Liste von Dokumentreferenzen (und optional Positionsinformationen) vorgehalten. Dadurch sind Containment-Checks – also die Frage, welche Dokumente ein bestimmtes Keyword enthalten – schnell und exakt. Die Kehrseite sind ein größerer Index auf der Festplatte sowie langsamere Schreibvorgänge, da Updates diese Posting-Listen pflegen müssen. Für leseintensive Workloads ist das in der Regel akzeptabel, weshalb GIN die Standardwahl für die meisten Textsuche-Szenarien darstellt.
GiST funktioniert anders. Anstatt vollständige Posting-Listen zu speichern, wird jeder tsvector in eine kleine Bitmaske, eine sogenannte Signature, komprimiert. Diese Signaturen fassen zusammen, welche Lexeme in einem Dokument vorkommen, sind jedoch nicht vollkommen präzise. Da unterschiedliche Dokumente dasselbe Bitmuster erzeugen können, kann GiST Zeilen zurückliefern, die nur potenziell passen. PostgreSQL muss in diesem Fall den zugrunde liegenden tsvector erneut prüfen. Der Vorteil ist ein kleinerer Index, der sich schneller erstellen lässt und günstiger in der Aktualisierung ist. Der Nachteil sind gelegentliche False Positives und langsamere komplexe Abfragen.
Welche Option ist die richtige? Wählen Sie GIN, wenn Sie schnelle und präzise Textsuche benötigen und leicht langsamere Indexpflege akzeptieren können. Wählen Sie GiST, wenn Sie viele Schreibvorgänge, häufige Updates oder begrenzten Speicher haben und einen zusätzlichen Recheck-Schritt tolerieren können.
Beispiel:
CREATE INDEX idx_products_search_vector_gin ON products USING GIN (search_vector);
CREATE INDEX idx_products_search_vector_gist ON products USING GIST (search_vector gist_tsvector_ops);
Ausführen einer Full-Text-Suche
Um eine Full-Text-Suche in PostgreSQL auszuführen, wird eine rohe Textanfrage zunächst in das TSQUERY-Format umgewandelt. Ein TSQUERY ist die Query-Repräsentation, die PostgreSQL verwendet, um gegen TSVECTOR-Spalten zu matchen – ähnlich wie ein Embedding-Vektor zur Abfrage eines Vector-Index genutzt wird. Das TSQUERY definiert die Suchbegriffe und die logische Verknüpfung, und PostgreSQL prüft damit, welche Dokumente passen.
Die Umwandlung der Eingabe in ein TSQUERY ist aufwendiger als bei der Vektorsuche. Bei Embeddings wird ein Vektor einmal berechnet und anschließend damit gesucht. Bei der keywordbasierten Suche muss entschieden werden, wie eine natürliche Sprachabfrage in ein sinnvolles TSQUERY überführt wird. Rohanfragen von Nutzern oder von einem LLM in einem RAG-System sind in der Regel nicht für Keyword-Suche optimiert.
Die einfachste Umwandlung ist plainto_tsquery. Diese Funktion normalisiert den Text, entfernt Stopwords und lemmatisiert Begriffe, erzeugt jedoch immer eine AND-Abfrage. Alle Terme müssen im Dokument vorkommen, was in der Praxis häufig zu restriktiv ist.
SELECT plainto_tsquery('english', 'deep learning models'); -- 'deep' & 'learn' & 'model'
Wenn ein höherer Recall erforderlich ist, gibt es zwei Alternativen:
Post Processing: Verbessern Sie die Anfrage vor dem Aufruf von FTS. Dabei können eigene Heuristiken angewendet oder ein LLM genutzt werden, um die Query zu formen (z. B. wenn es als Tool eingesetzt wird). PostgreSQL stellt mit websearch_to_tsquery eine Funktion bereit, die eine Google-ähnliche Syntax akzeptiert und bei fehlerhafter Eingabe keine Errors wirft. Dies ist besonders nützlich, wenn die Query bereits vorverarbeitet wurde.
AND-Abfrage in OR umwandeln: Erzeugen Sie das TSQUERY zunächst mit plainto_tsquery (wie oben gezeigt), um von Parsing und Normalisierung zu profitieren, und ersetzen Sie anschließend & durch |. Dieser kleine „Hack“ erweitert die Treffermenge ohne zusätzliche Latenz, ohne LLM-Aufrufe und ohne eigene Heuristiken, sollte jedoch mit Vorsicht eingesetzt werden. OR-Abfragen können sehr schnell zu breit werden, insbesondere wenn die Eingabe Begriffe enthält, die nicht als Stopwords entfernt werden. Im Extremfall matchen nahezu alle Dokumente, wodurch der Filter-Schritt an Wert verliert. Es ist eine schnelle Möglichkeit, den Recall zu erhöhen, kann die Filterwirkung jedoch deutlich schwächen.
Mit dem berechneten TSQUERY läuft eine Full-Text-Suche in zwei Schritten ab. Zunächst werden die Zeilen mithilfe des TSQUERY und des @@-Operators gefiltert, was vom FTS-Index profitiert. Dieser Schritt bestimmt, welche Dokumente überhaupt matchen. Anschließend werden die passenden Zeilen nach Relevanz gerankt. Ranking ist langsamer als indexbasiertes Filtern, weshalb es – obwohl der erste Schritt technisch optional ist – empfohlen wird, die Treffermenge klein zu halten, um die Latenz beim Ranking zu minimieren.
PostgreSQL stellt zwei Funktionen zur Berechnung eines Relevanz-Scores bereit: ts_rank und ts_rank_cd. Beide nehmen einen TSVECTOR (Dokument) und ein TSQUERY (Anfrage) entgegen und liefern einen numerischen Score zurück, wobei höhere Werte eine bessere Übereinstimmung bedeuten.
ts_rank bewertet Dokumente auf Basis der Termfrequenz und optionaler Gewichtungen. Häufigeres Vorkommen von Suchbegriffen erhöht den Score, jedoch mit abnehmendem Grenznutzen. Sehr häufige Terme werden abgewertet, sodass sie das Ranking nicht dominieren.
ts_rank_cd enthält die gesamte Logik von ts_rank, ergänzt diese jedoch um Cover Density. Dabei wird berücksichtigt, wie nah die Suchbegriffe beieinander im Text auftreten. Dokumente, in denen die Begriffe in einem engen Kontext erscheinen, erhalten einen höheren Score als solche, in denen sie weit auseinanderliegen. Dies verbessert das Ranking insbesondere bei Mehrwortanfragen, da eine enge Häufung meist auf einen relevanteren Kontext hindeutet. Die zusätzliche Logik macht ts_rank_cd langsamer, da Positionsdaten ausgewertet werden müssen. Bei kurzen Dokumenten oder Einwortanfragen ist der Unterschied gering, bei längeren Dokumenten oder Mehrwortanfragen liefert ts_rank_cd in der Regel bessere Rankings.
Beide Funktionen unterstützen eine Normalisierungs-Bitmaske, um rohe Scores anzupassen. Normalisierung kann eine Verzerrung zugunsten langer Dokumente reduzieren und Scores in vergleichbare Bereiche skalieren. Bit 1 teilt durch 1 + log(document_length) und Bit 2 durch die Dokumentlänge, was jeweils den Längeneffekt reduziert. Die Bits 4 und 8 berücksichtigen die Anzahl eindeutiger Terme für die Skalierung. Bit 32 wird in der Praxis häufig verwendet und transformiert Scores zu score / (score + 1), wodurch Werte zwischen 0 und 1 entstehen.
Zusammengefasst kombiniert eine typische Full-Text-Suche das Filtern mit @@ und das Ranking mit ts_rank oder ts_rank_cd. Der Filter nutzt den FTS-Index, um Kandidaten schnell zu selektieren, und das Ranking ordnet anschließend nur diese Treffer. Ein Beispiel könnte wie folgt aussehen:
SELECT id, title, ts_rank_cd(search_vector, query, 32) AS score
FROM products
WHERE search_vector @@ query
ORDER BY score DESC
LIMIT 10;
Hybrides Retrieval: Kombination von pgvector und FTS
Nachdem sowohl Vektorsuche als auch keywordbasierte Suche eingerichtet sind, können beide Verfahren kombiniert werden, um die Ergebnisqualität zu verbessern. Hybride Suche vereint semantische Treffer aus pgvector mit Keyword-Treffern aus der Full Text Search. Dazu werden zwei unabhängige Abfragen ausgeführt – eine Vektorsuche und eine FTS – und die Ergebnisse anschließend zusammengeführt. Beide Abfragen können parallel ausgeführt werden.
Reciprocal Rank Fusion (RRF) kombiniert die beiden Ergebnislisten, indem jedem Dokument ein Score auf Basis seiner Rangposition in den einzelnen Listen zugewiesen und diese Beiträge aufsummiert werden. RRF ist in vielen Retrieval-Setups beliebt, da es einfach, rangbasiert und robust gegenüber Ausreißern ist.
Dabei gilt:
r = Rangposition des Dokuments d in einer Ergebnisliste (1 = bester Rang)
Rd = Menge der Rangpositionen von d über alle Listen hinweg
k = Konstante zur Glättung des Beitrags niedriger gerankter Ergebnisse
Der Wert von k wird üblicherweise auf 60 gesetzt, basierend auf empirischen Auswertungen in der Information-Retrieval-Literatur, bei denen dieser Wert eine stabile Leistung über alle Benchmarks hinweg ohne Anpassung ergab. Größere Werte verringern den Einfluss von Ergebnissen am Ende der Rangliste und stellen sicher, dass die am besten bewerteten Dokumente die fusionierte Bewertung dominieren.
Insgesamt erspart die RRF die Kalibrierung oder Normalisierung der Ergebnisse verschiedener Suchmethoden. Sie ist ein praktischer Standard bei der Kombination von Vektor- und Stichwortsuche.
Beim Einsatz von PostgreSQL als Grundlage für ein RAG-System werden häufig nutzerspezifische Daten gemeinsam mit geteilten Inhalten gespeichert. Eine reine Vektorsuche garantiert dabei keine Isolation: Ohne zusätzliche Regeln können Embeddings und Textzeilen verschiedener Nutzer in den Ergebnissen auftauchen. Um Datenlecks zwischen Nutzern zu verhindern und sicherzustellen, dass jede Anfrage nur Daten zurückliefert, die der aufrufenden Partei zustehen, wird Zugriffskontrolle auf Tabellenebene durchgesetzt.
Row-Level Security (RLS) ist ein Feature von PostgreSQL, das eine fein granulare Kontrolle darüber ermöglicht, auf welche Zeilen ein Benutzer oder eine Rolle zugreifen oder welche sie verändern darf. RLS erzwingt Einschränkungen innerhalb einer Tabelle und stellt sicher, dass jede Abfrage ausschließlich die Zeilen sieht, für die sie berechtigt ist.
Einer der größten Vorteile von RLS besteht darin, dass Zugriffsregeln direkt in der Datenbank durchgesetzt werden, anstatt über den Anwendungscode verteilt zu sein. Diese Zentralisierung bedeutet, dass es genau einen Ort gibt – die Policy auf der Datenbanktabelle –, an dem die Sicherheitslogik definiert und gepflegt wird. Dadurch sinkt das Risiko, dass ein Fehler in der Anwendung Daten offenlegt (zum Beispiel ein fehlender Filter in einem API-Endpunkt). Ist RLS auf einer Tabelle korrekt konfiguriert, enthalten alle Abfragen (SELECT, UPDATE, DELETE), die von nicht privilegierten Rollen ausgeführt werden, automatisch den Sicherheitsfilter. Eine fehlerhaft geschriebene Query kann ihn somit nicht umgehen.
Aktivieren und Anwenden von Row-Level-Security-Policies
RLS wird über Policies implementiert, die auf Tabellen definiert sind. Standardmäßig besitzen Tabellen keine RLS-Policy. Hat ein Benutzer SELECT-Rechte, kann er daher alle Zeilen sehen. Sobald RLS aktiviert ist, verlangt PostgreSQL, dass jede Zeile vor der Rückgabe oder Änderung eine Policy-Prüfung besteht. Ist RLS aktiviert, aber keine Policy definiert, gilt standardmäßig „deny all“: Es sind weder Zeilen sichtbar noch bearbeitbar, bis eine Policy hinzugefügt wird.
Das Aktivieren von RLS auf einer Tabelle erfolgt mit folgendem Befehl:
ALTER TABLE my_table ENABLE ROW LEVEL SECURITY;
Nach der Aktivierung erstellen Sie eine oder mehrere Richtlinien mit CREATE POLICY. Eine Richtlinie definiert einen booleschen Ausdruck, der Zeilen für bestimmte Operationen (SELECT, INSERT, UPDATE, DELETE) filtert und kann für bestimmte Rollen oder für PUBLIC (alle Rollen) gelten. Um beispielsweise Selects in einer Dokumententabelle auf Zeilen zu beschränken, deren owner_id mit der ID des aktuellen Benutzers übereinstimmt, könnten Sie schreiben:
CREATE POLICY docs_select_own ON documents
FOR SELECT
USING (owner_id = current_setting('app.user_id'))::int);
Für Schreiboperationen sollten WITH CHECK-Klauseln in INSERT- und UPDATE-Policies verwendet werden, um sicherzustellen, dass Benutzer keine Zeilen anlegen oder verändern können, die für sie später nicht sichtbar wären.
Wichtig: RLS arbeitet zusammen mit dem regulären Berechtigungssystem von PostgreSQL, ersetzt dieses jedoch nicht. Ein Benutzer muss weiterhin die entsprechenden Tabellenrechte besitzen (vergeben über GRANT), um Operationen ausführen zu dürfen. RLS fügt darauf lediglich eine zusätzliche Filterebene hinzu. So kann beispielsweise GRANT SELECT ON documents TO app_user_role einer Rolle grundsätzlich Lesezugriff geben, während die RLS-Policies festlegen, welche Zeilen tatsächlich sichtbar sind. Hat ein Benutzer kein SELECT-Recht, gewährt RLS dieses nicht – die Tabelle kann schlicht nicht abgefragt werden.
Berechtigungsverhalten unter RLS
Superuser und Rollen mit dem Attribut BYPASSRLS überspringen Row-Level-Security-Prüfungen vollständig. Auch der Owner einer Tabelle ist standardmäßig ausgenommen, da Tabellenbesitzer typischerweise administrative Rollen sind. Verbindet sich Ihre Anwendung daher als Tabellen-Owner oder als Superuser, werden RLS-Policies in dieser Session nicht durchgesetzt.
Um sicherzustellen, dass RLS greift, sollte die Anwendung eine dedizierte Rolle verwenden, die nicht Eigentümer der Tabellen ist. Erstellen Sie beispielsweise eine Rolle app_user mit eingeschränkten Rechten und lassen Sie die Anwendung als diese Rolle authentifizieren. Gewähren Sie Zugriff auf die benötigten Tabellen, ohne Ownership zu vergeben. In dieser Konfiguration werden RLS-Policies wie vorgesehen ausgewertet.
Permissive vs. Restriktive Policies
PostgreSQL-Policies sind standardmäßig permissive. Mehrere permissive Policies auf einer Tabelle werden mit einem logischen ODER verknüpft – sobald eine Policy Zugriff erlaubt, ist die Zeile zugänglich. Dadurch eignen sich permissive Policies gut für breite, allgemeine Regeln.
Beispielsweise könnte eine permissive Policy für alle Operationen (*) definiert werden, die es jedem Mitarbeiter erlaubt, Dokumente innerhalb der eigenen Organisation zu lesen und zu aktualisieren:
CREATE POLICY docs_org_policy ON documents
FOR ALL
USING (org_id = current_setting('app.org_id'))::int);
In manchen Fällen sind jedoch strengere Regeln für bestimmte Operationen erforderlich. Hier kommen restrictive Policies zum Einsatz. Restrictive Policies werden mit einem logischen UND kombiniert – alle restriktiven Bedingungen müssen erfüllt sein, zusätzlich zu etwaigen permissiven Policies.
Um beispielsweise sicherzustellen, dass nur der Eigentümer ein eigenes Dokument löschen kann, kann eine restrictive Policy für DELETE definiert werden:
CREATE POLICY docs_delete_own ON documents
AS RESTRICTIVE
FOR DELETE
USING (owner_id = current_setting('app.user_id'))::int);
Diese Kombination ermöglicht eine geschichtete Zugriffskontrolle: Permissive Policies definieren die Basis, während restrictive Policies die Einschränkungen für sensible Operationen weiter verschärfen
PostgreSQL kann als praxisnaher Vector Store für RAG-Systeme dienen, indem pgvector für semantisches Retrieval mit Full Text Search für keywordbasierte Suche kombiniert wird. Einfache Fusionsmethoden wie Reciprocal Rank Fusion verbessern die Ergebnisqualität, ohne eine komplexe Kalibrierung von Scores zu erfordern, und beide Sucharten lassen sich parallel ausführen. Row-Level Security verhindert anschließend Datenlecks zwischen Nutzern, indem Zugriffsregeln direkt innerhalb der Datenbank-Engine durchgesetzt werden. Zusammengenommen ermöglichen diese Funktionen den Aufbau einer Retrieval-Pipeline auf vertrauter Infrastruktur – mit fein abstimmbarer Performance, zentralisierter Autorisierung und minimalem operativem Aufwand.
https://www.scieneers.de/wp-content/uploads/2025/12/blog_image-1-scaled.png14452560Arne Grobrueggehttps://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.pngArne Grobruegge2025-12-15 09:44:152026-01-14 08:22:50Implementierung von RAG mit PostgreSQL
Einmal mehr stand das Team im Mittelpunkt: Beim zweitägigen Herbstevent Ende September kamen alle scieneers aus Karlsruhe, Köln und Hamburg zusammen. Neben spannenden Austauschrunden und gemeinsamen Aktivitäten durften wir auch fünf neue Kolleg:innen willkommen heißen. Nun sind wir ein rund 50-köpfiges Team!
Drei Tage voller Talks, Tutorials und Tech-Community-Spirit – das war die PyData Berlin 2025 im bcc Berlin Congress Center. Im Fokus standen Open-Source-Tools, Agentic AI und die Frage: Wie lassen sich LLMs produktiv und kontrolliert einsetzen? Wir von scieneers waren mit einem Vortrag zu LiteLLM vertreten – „One API to Rule Them All? LiteLLM in Production“.
Missense-Varianten, also einzelne Aminosäureaustausche im Protein, sind oft schwer zu bewerten. Unser Machine-Learning-Workflow nutzt proteinstrukturbasierte Graph-Embeddings, um die Pathogenität solcher Varianten vorherzusagen. Dabei verbessern die strukturellen Informationen bestehende Ansätze wie den CADD-Score und bieten neue Einblicke für die genommedizinische Diagnostik.
Zwei Tage lang haben sich die meisten Kolleginnen und Kollegen aus Karlsruhe, Köln und Hamburg in Hamburg getroffen, um sich über fachliche und interne Themen auszutauschen, neue Impulse zu erhalten und gemeinsame Erlebnisse zu teilen.
Nachdem wir uns im letzten Artikel einen Überblick über Real-Time Intelligence in Microsoft Fabric verschafft haben, gehen wir heute eine Ebene tiefer und betrachten Eventstreams etwas genauer.
Events & Streams allgemein
Vergegenwärtigen wir uns als Einstieg einmal ganz unabhängig von Fabric, was ein „Event“ bzw. „Eventstream“ ist.
Stellen wir uns zum Beispiel vor, dass wir in einem Lagerhaus verderbliche Lebensmittel lagern. Wir wollen sichergehen, dass es immer kühl genug ist, und deshalb die Temperatur überwachen. Dazu haben wir einen Sensor installiert, der einmal pro Sekunde die aktuelle Temperatur übermittelt.
Wann immer das geschieht, nennen wir das ein Event. Über die Zeit hinweg betrachtet haben wir dann eine Folge von Events, die (theoretisch) niemals endet – also einen Stream von Events.
Auf abstrakter Ebene ist ein Event ein Datenpaket, das zu einem bestimmten Zeitpunkt emittiert wird und typischerweise eine Zustandsänderung beschreibt – etwa bei Temperaturen, Aktienkursen oder Fahrzeug-Standorten.
Eventstreams in Fabric
Kommen wir zu Microsoft Fabric. Hier repräsentiert ein Eventstream einen Strom von Events, der von (mindestens) einer Quelle ausgeht, optional transformiert wird und an (mindestens) ein Ziel geleitet wird.
Schön dabei ist, dass das Ganze komplett ohne Coding funktioniert. Eventstreams können ganz einfach über die Benutzeroberfläche im Browser erstellt und konfiguriert werden.
Hier ein Beispiel, wie ein Eventstream aussehen kann:
Jeder Eventstream setzt sich aus 3 verschiedenen Arten von Bausteinen zusammen, die wir uns im Folgenden genauer anschauen:
① Quellen
② Transformationen
③ Ziele
① Quellen
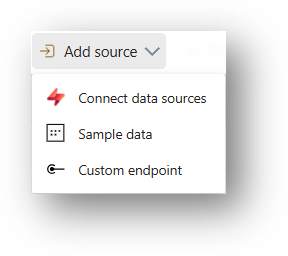
Für den Anfang braucht man eine Datenquelle, die Events liefert.
Technologisch gibt es hier eine große Auswahl an unterstützten Möglichkeiten. Neben Microsoft-Technologien (z.B. Azure IoT Hub, Azure Event Hub, OneLake events) umfasst diese u.a. auch Apache Kafka-Streams, Amazon Kinesis Data Streams, Google Cloud Pub/Sub und Change Data Captures.
Wenn das alles nicht reicht, kann man einen Custom Endpoint nutzen. Dieser unterstützt die Protokolle Kafka, AMQP und außerdem Event Hub. Eine Übersicht aller unterstützten Quellen gibt es hier.
Tipp: Von Microsoft gibt es verschiedene „Sample“-Datenquellen, die zum Ausprobieren und Experimentieren sehr praktisch sind.
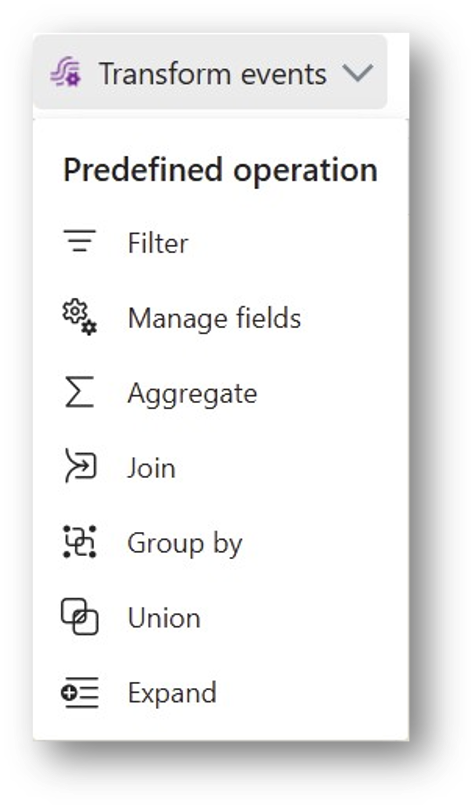
② Transformationen
Die Eventdaten können nun auf verschiedene Weise bereinigt und transformiert werden. Dazu fügt man nach der Quelle einen der Transformationsoperatoren hinzu und konfiguriert diesen. Man kann so u.a. die eingehenden Daten filtern, kombinieren und aggregieren, Felder auswählen usw.
Beispiel: Nehmen wir an, die Datenquelle liefert uns mehrmals pro Sekunde die aktuelle Raumtemperatur, aber für unsere geplante Analyse wäre eine Granularität von einer Minute schon vollkommen ausreichend. Wir nutzen deshalb „Group by“ um pro Zeitfenster von 5 Sekunden die durchschnittliche, minimale und maximale Temperatur zu berechnen. Damit reduzieren wir das Datenvolumen (und damit verbundene Kosten) vor dem Abspeichern beträchtlich und erhalten trotzdem alle relevanten Informationen.
③ Ziele (Destinations)
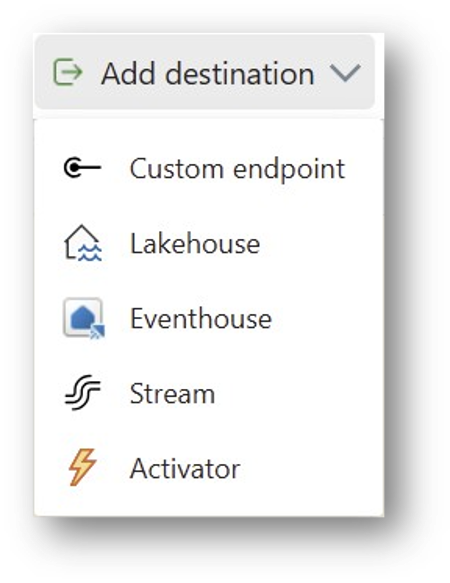
Nach Durchlaufen aller Transformationsschritte werden die Eventdaten an ein Ziel geleitet. Meistens ist das Ziel eine Tabelle in einem Eventhouse. Ingesamt unterstützt werden:
Eventhouses: Ein Eventhouse ist ein für Events optimierter Datenspeicher in Fabric, der kontinuierliches Einspeisen neuer Daten und sehr schnelle Analysen darauf unterstützt. Auf Eventhouses werden wir im Detail in einem weiteren Blog-Post eingehen.
Lakehouse: Ein Lakehouse ist der „typische“ Datenspeicher in Fabric in klassischen (Batch-)Szenarien. Es unterstützt sowohl strukturierte als auch unstrukturierte Daten.
Activator: Ein Activator ermöglicht es, unter bestimmten Bedingungen Aktionen auszulösen. Zum Beispiel könnte automatisch eine E-Mail verschickt werden, wenn die gemessene Temperatur einen Schwellwert überschreitet. Für komplexere Fälle kann man einen Power Automate Flow auslösen.
Stream: Ein weiterer Eventstream („abgeleiteter Stream“). Man hat also die Möglichkeit, Eventstreams zu verketten. Das kann hilfreich sein, um komplexe Logik aufzubrechen und Wiederverwendung zu ermöglichen.
Custom Endpoint: Analog zu den Quellen kann man auch als Ziel einen Custom Endpoint nutzen und so beliebige Drittsysteme anbinden. Unterstützt werden auch hier Kafka, AMQP und Event hub.
Eventstreams unterstützen auch mehrere Ziele. Das kann hilfreich sein, wenn man zum Beispiel eine Lambda-Architektur umsetzen möchte: Man speichert feingranulare Daten (z.B. auf Sekundenbasis) für begrenzte Zeit in einem Eventhouse, um Echtzeitszenarien zu unterstützen. Parallel dazu aggregiert man die Daten (z.B. auf Minutenbasis) und speichert das Ergebnis für historische Datenanalysen in einem Lakehouse.
Kosten
Um Eventstreams nutzen zu können, braucht man eine kostenpflichtige Fabric Capacity. Microsoft empfiehlt dabei mindestens eine F4 SKU (die monatlichen Preise dafür findet man hier). Welche Ausbaustufe tatsächlich ausreichend ist, hängt von mehreren Faktoren ab – insbesondere der benötigten Rechenleistung, dem Datenvolumen und der Eventstream-Laufzeit. Details kann man hier nachlesen.
Sollte man einen Eventstream vorübergehend nicht benötigen, kann man ihn deaktivieren und so vermeiden, seine Fabric Capacity unnötig zu belasten. Genau genommen geht dies sogar separat für alle Quellen und Ziele.
In der heutigen Geschäftswelt versucht man mehr und mehr, Entscheidungen und Prozesse auf ein solides Fundament von Daten zu stellen. Die technische Antwort darauf sind typischerweise Data Warehouses und Dashboards, die Unternehmensdaten bündeln und durch Visualisierung für jeden verständlich und nutzbar machen.
In der Umsetzung verlässt man sich häufig auf Batch-Processing, bei dem die Daten in einem automatischen Prozess gesammelt und aufbereitet werden – beispielsweise einmal pro Tag, seltener schon stündlich oder im Abstand von einigen Minuten.
Dieser Ansatz funktioniert für viele Anwendungsfälle gut. Er stößt aber dann an seine Grenzen, wenn wir Informationen „in Echtzeit“ analysieren möchten und höchstens eine Verzögerung von wenigen Sekunden in Kauf nehmen können. Einige Beispiele:
Produktion: Überwachung von Sensordaten, um Maschinenausfälle zu vermeiden („Predictive Maintenance“)
Supply Chain: Tracking von Standortdaten und Wetterereignissen, um Lieferverzögerungen frühzeitig zu erkennen
Finanzwesen: Sekundengenaue Überwachung und Analyse von Aktienkursen
IT: Auswertung von Log-Daten, um nach Updates Probleme sofort zu erkennen
Marketing: Analyse von Social Media Posts während einem Live-Event
Neu ist das alles nicht, aber bisherige Lösungen waren in der Umsetzung oft aufwendig und erforderten viel Fachwissen.
Genau hier hat Microsoft angesetzt: 2024 wurde die Fabric-Plattform mit Real-Time Intelligence um verschiedene Bausteine erweitert, mit denen man einen Großteil der Komplexität umgeht und schnell zu funktionierenden Lösungen kommt.
In kommenden Artikeln erklären wir die wichtigsten dieser Bausteine „Fabric Items“ genauer. Hier ein kurzer Überblick:
Eventstream
Eventstreams empfangen kontinuierlich Echtzeitdaten (Events) aus verschiedensten Quellen. Diese werden bei Bedarf transformiert und letztlich an ein Ziel weitergeleitet, das für die Speicherung der Daten zuständig ist. Typischerweise ist das Ziel ein Eventhouse. Code wird nicht benötigt.
Eventhouse
Ein Eventhouse ist ein optimierter Datenspeicher für Events. Es enthält mindestens eine KQL-Datenbank, in der die Event-Daten in Tabellenform gespeichert werden.
Real-Time Dashboard
Real-Time Dashboards haben Ähnlichkeit zu Power-BI-Reports, sind aber eine von Power BI unabhängige, eigenständige Lösung. Ein Real-Time Dashboard enthält Kacheln mit Visuals (z.B. Diagramme oder Tabellen). Diese sind interaktiv und man kann etwa Filter setzen. Jedes Visual holt sich die notwendigen Daten über eine Datenbankabfrage, die man in KQL (Kusto Query Language) formuliert – typischerweise aus einem Eventhouse.
Activator
Activator ermöglicht es, unter bestimmten Bedingungen automatisch eine Aktion auszuführen, beispielsweise basierend auf einem Real-Time Dashboard oder einer KQL Query. Die Aktion ist im einfachsten Fall das Senden einer Nachricht per E-Mail oder Teams; man kann aber auch einen Power Automate Flow anstoßen.
Was muss ich also lernen, um mit Real-Time Intelligence eine Lösung umzusetzen?
Es läuft im Wesentlichen auf KQL und ein Grundverständnis der erwähnten Fabric Items hinaus. Vieles ist No-Code. KQL ist zwar im Vergleich zu SQL weniger verbreitet, die Grundlagen sind aber leicht zu lernen und es fühlt sich schon nach kurzer Zeit natürlich an.
In unserem Blogmelden wir uns bald mit weiteren Posts zum Thema Fabric Real-Time Intelligence und steigen tiefer in die verschiedenen Themenbereiche ein.
https://www.scieneers.de/wp-content/uploads/2025/05/real_time_intelligence_1030x258.jpg258344Rupert Schneiderhttps://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.pngRupert Schneider2025-05-23 09:37:392025-08-22 13:05:49Real-Time Intelligence: Echtzeitdaten in Microsoft Fabric