Time Series Foundation Models in Practice

Können Time-Series-Foundation-Models die Wärmebedarfsprognose in Fernwärmenetzen verbessern? In unserer Offline-Studie vergleichen wir Chronos-2, TimesFM-2.5 und Moirai-2 mit AutoARIMA, XGBoost und weiteren Baselines auf der Grundlage realer Daten aus vier Fernwärmenetzen. Chronos-2 erzielte die besten Ergebnisse, sogar im Zero-Shot-Einsatz ohne Trainingsdaten aus dem Zielnetz. Der Beitrag untersucht die Dateneffizienz, das Fine-Tuning, die Robustheit bei fehlerhaften Sensordaten und die Zuverlässigkeit im Betrieb.
Rückblick: Unser Workshop zu Retrieval-Augmented Generation (RAG)

Rund 30 Teilnehmende aus den Bereichen Wohlfahrtsverbände, Entwicklungszusammenarbeit, Digitalpolitik, Wissenschaft und lokale Zivilgesellschaft nahmen an unserem kostenlosen RAG-Workshop mit dem Civic Data Lab teil. Zwei Stunden lang ging es um die Grundlagen von Retrieval-Augmented Generation, eine Hands-on-Session und die Frage, wann RAG das passende Werkzeug ist. Den Rückblick mit den Folien zum Download finden Sie hier.

Rückblick auf unser Herbstevent 2026

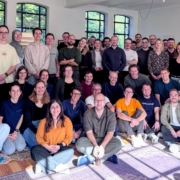
Beim scieneers Herbstevent 2026 kamen Kolleg:innen aus fünf Standorten in Hamburg zusammen. Zwei Tage lang standen fachliche Sessions, Teamarbeit, persönliche Lightning Talks und gemeinsamer Austausch im Mittelpunkt.

Data Product Ownership

Der Data Product Owner spielt eine zentrale Rolle bei der Entwicklung erfolgreicher Datenprodukte. Neben den Aspekten Desirability, Viability und Feasibility muss er zusätzlich die Perspektive „Datability” managen, denn Unsicherheit, Datenqualität und iterative Weiterentwicklung prägen jedes Datenprojekt. Der Beitrag zeigt, welche Aufgaben und Kompetenzen einen guten Data Product Owner ausmachen und wie sich diese Rolle von der des Data Scientists abgrenzt.

Rückblick auf unser Frühlingsevent 2026

Beim diesjährigen Frühlingsevent in Köln kamen Kolleg:innen aus allen Standorten zusammen, darunter erstmals auch welche aus Berlin und München. Zwei Tage lang standen Austausch, Teamkultur und spannende interne Themen im Mittelpunkt – von Leistungsbeurteilung und Feedback über KI-Ethik bis hin zu Diversity, Co-Design und gemeinsamen Aktivitäten in Köln. Der Rückblick zeigt, wie wertvoll persönliche Begegnungen sind, wenn ein Team weiter wächst und zugleich eng verbunden bleiben möchte.

Frühlingskonferenzen 2026: PyCon DE und PyData & Minds Mastering Machines

Bei den Frühlingskonferenzen 2026 drehte sich alles um KI, Daten und praxisnahe Engineering-Themen. Auf der PyCon DE & PyData sowie der Minds Mastering Machines hielten wir Vorträge zu RAG-Pipelines mit multimodalen Embeddings, Spec-Driven Development, Genolator und KI-Bildgenerierung. Dieser Beitrag gibt einen kompakten Überblick über die wichtigsten Inhalte, technischen Erkenntnisse und zentralen Erkenntnisse der Konferenzen.

Bewerbungsprozess bei scieneers

Du möchtest Teil von scieneers werden? Hier erfährst du Schritt für Schritt, wie unser Bewerbungsprozess aussieht – von der Online-Bewerbung über Remote-Interviews bis zum Kennenlernen vor Ort. Finde heraus, ob wir zueinander passen, und entdecke, was im Bewerbungsprozess besonders wichtig ist: Persönlichkeit, Eigeninitiative und Begeisterung für Technik.

PoC vs Prototyp vs MVP vs Pilot

Bei der Planung von Datenprodukten oder Softwareprojekten entsteht oft erst durch eine klare Abgrenzung der Entwicklungsphasen Klarheit.
Ein stufenweiser Aufbau reduziert die Unsicherheit schrittweise und gleicht die Erwartungen in interdisziplinären Teams an.

Wärmebedarf prognostizieren mit Temporal Fusion Transformern

Globale Modelle wie TFT und TimesFM revolutionieren die Fernwärmeprognose, indem sie präzisere Vorhersagen ermöglichen, Synergien zwischen Systemen nutzen und das Cold-Start-Problem effektiv lösen.

Optimize an AI Powered Recommendation Engine

scieneers, Intel Corporation, and Von Rundstedt joined forces to optimize an AI powered recommendation engine solution that leverages the Intel® AI Analytics Toolkit and 4th Generation Intel® Xeon® Scalable Processors. In this brief experience report we demonstrate how we managed to achieve up to 9.3X speedup when running on 4th Generation Intel® Xeon® Scalable Processors compared to the baseline configuration. This means that the solution can process more data faster, generate more accurate recommendations, and serve more users with lower latency and cost.