

 https://www.scieneers.de/wp-content/uploads/2026/10/Power-BI-Customs-Visuals-Blog-Post-Bild-1-scaled.jpg
1429
2560
shinchit.han@scieneers.de
https://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.png
shinchit.han@scieneers.de2026-10-09 16:40:342026-10-12 09:57:09Power BI Custom Visuals
Die Suche nach der Nadel im genomischen Heuhaufen
Genommedizin trifft auf Machine Learning
Jedes Genom enthält ungefähr 3,5 Millionen genetische Varianten.
Die meisten davon haben keinerlei Wirkung.
Doch manchmal kann schon eine einzige Veränderung eines DNA‑Buchstabens eine lebensbedrohliche Krankheit verursachen.
Diese eine Variante unter Millionen zu finden, gehört zu den zentralen Herausforderungen der Genommedizin.
Als ich angefangen habe am Zentrum für Humangenetik und Genommedizin in Aachen zu arbeiten, hat mich eine Zahl besonders überrascht:
350 Millionen.
So viele Menschen leben weltweit mit einer seltenen Erkrankung.
In der EU gilt eine Krankheit als selten, wenn weniger als 1 von 2.000 Menschen betroffen ist. Für sich genommen klingt das ungewöhnlich — doch in Summe betreffen seltene Erkrankungen Millionen von Menschen.
(Quelle: European Commission)
Allein in Deutschland leben rund 4 Millionen Menschen mit einer seltenen Erkrankung.
🧬 Viele seltene Erkrankungen gehen auf eine einzige genetische Veränderung zurück
Was viele nicht wissen: Die meisten seltenen Erkrankungen werden durch eine einzelne genetische Variante verursacht.
Eine der häufigsten Formen ist die sogenannte Single Nucleotide Variant (SNV) — eine Veränderung von nur einem einzigen Buchstaben in unserer DNA.
Unsere DNA besteht aus vier Nukleotiden:
- A – Adenin
- T – Thymin
- G – Guanin
- C – Cytosin
Während der Proteinbiosynthese wird diese DNA‑Sequenz zunächst in Messenger‑RNA (mRNA) transkribiert und anschließend in Proteine übersetzt, die fast alle Funktionen in unseren Zellen ausführen.
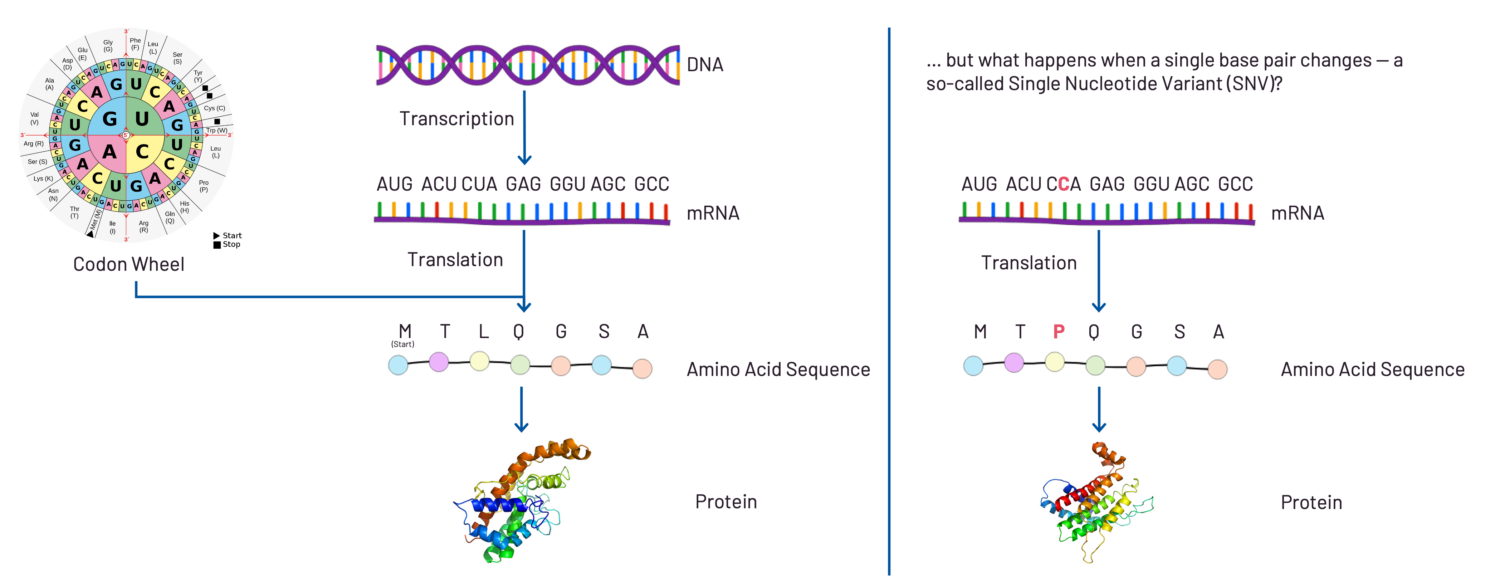
Missense‑Varianten erklärt anhand der Proteinbiosynthese: Rechts ist eine Single Nucleotide Variant dargestellt, die zu einer Missense‑Variante führt. Weitere Variantentypen sind Nonsense‑, Synonyme- und Loss‑of‑Function‑Varianten.
Wenn sich ein einzelnes Nukleotid verändert, kann sich auch das daraus resultierende Protein verändern.
Diese Varianten können unterschiedliche Konsequenzen haben, zum Beispiel:
- Missense‑Varianten verändern eine Aminosäure im Protein
- Nonsense‑Varianten führen zu einem vorzeitigen Stoppsignal
- Synonyme Varianten lassen die Aminosäure unverändert
Die Schwierigkeit besteht darin, dass nicht jede Veränderung schädlich ist.
Tatsächlich trägt der durchschnittliche Mensch mehr als 9.000 Missense‑Varianten und die überwiegende Mehrheit davon ist völlig harmlos.
(Quelle: Exome sequencing and analysis of 454,787 UK Biobank participants)
Wenn Kliniker also das Genom eines Patienten analysieren, suchen sie im Grunde nach einer einzigen krankheitsverursachenden Variante unter Millionen.
Ein klassisches Nadel im Heuhaufen Problem.
🧠 Hier kommt Machine Learning ins Spiel
Die Herausforderung wird noch größer, wenn man bedenkt, wie viel vom Genom wir noch immer nicht vollständig verstehen.
Nur etwa 2 % des Genoms kodieren direkt für Proteine, zumindest nach dem aktuellen Stand der Wissenschaft. Die übrigen 98 % — manchmal als „Dark Genome“ bezeichnet — sind deutlich schwerer zu interpretieren, obwohl Varianten auch dort Krankheiten verursachen können.
(Quelle: Shedding light on the dark genome)
Um dieses Problem anzugehen, greifen Forschende zunehmend auf Machine Learning Modelle zurück, die abschätzen, ob eine Variante wahrscheinlich pathogen ist. Diese Modellierung wird als Variant Effect Prediction bezeichnet.
Werkzeuge wie AlphaMissense, CADD, SIFT, REVEL oder SpliceAI helfen dabei, Varianten zu priorisieren und die Suche einzugrenzen.
Ein besonders interessantes Modell darunter ist AlphaMissense, entwickelt von DeepMind.
AlphaMissense baut auf der Idee von AlphaFold auf — ein Modell zur Vorhersage von 3D-Proteinstrukturen, das Demis Hassabis und John Jumper im Jahr 2024 den Nobelpreis für Chemie eingebracht hat. Während AlphaFold die dreidimensionale Struktur von Proteinen aus ihrer Aminosäuresequenz vorhersagt, wurde AlphaMissense entwickelt, um die Auswirkungen von Missense‑Varianten zu bewerten.
Wie wir zuvor gesehen haben, verändern Missense‑Varianten eine einzelne Aminosäure in einem Protein. Ob diese Veränderung schädlich ist, hängt unter anderem stark davon ab, wie sie die Struktur und Funktion des Proteins beeinflusst.
Genau das versucht AlphaMissense abzuschätzen.
Das Modell vergibt einen Score zwischen 0 und 1, der widerspiegelt, wie wahrscheinlich es ist, dass eine Missense‑Variante pathogen statt harmlos ist. Diese Vorhersagen helfen Klinikern und Forschenden dabei, Varianten bei der Analyse von Patientengenomen zu priorisieren und bringen uns einen Schritt näher daran, die Nadel im genomischen Heuhaufen zu finden.
Als DeepMind AlphaMissense veröffentlichte, stellten sie außerdem Vorhersagen für 71 Millionen mögliche Missense‑Varianten im kodierenden Bereich unseres Genoms bereit.
(Quelle: A catalogue of genetic mutations to help pinpoint the cause of diseases)
Auch wenn die Modellgewichte selbst nicht veröffentlicht wurden (das Modell also nicht vollständig Open Source ist), stellte DeepMind eine Referenzimplementierung von AlphaMissense auf GitHub bereit, damit Forschende die Methodik nachvollziehen können:
👉 https://github.com/google-deepmind/alphamissense
Natürlich haben Modelle wie AlphaMissense auch ihre Grenzen.
Sie wurden speziell für Missense‑Varianten in protein‑kodierenden Regionen entwickelt. Das bedeutet, dass sie beispielsweise folgende Varianten nicht direkt bewerten können:
- Varianten in nicht‑kodierenden Regionen
- Insertionen und Deletionen (Indels)
- größere strukturelle Varianten
- Varianten, die Genregulation oder Splicing beeinflussen
Jeder dieser Variantentypen erfordert andere Modellierungsansätze.
🩸 Ein reales Beispiel: Sichelzellanämie
Doch wie sieht eine Krankheit aus, die tatsächlich durch eine einzelne Nukleotidveränderung verursacht wird?
Eines der faszinierendsten Beispiele ist die Sichelzellanämie — eine Mutation, die eine schwere genetische Erkrankung verursacht, gleichzeitig aber einen gewissen Schutz vor Malaria bietet.
Interessanterweise war genau diese Krankheit Thema in Gesprächen während eines Workshops, an dem ich vor zwei Jahren am CSIR‑IGIB in Neu‑Delhi teilgenommen habe.
Mehr dazu im nächsten Beitrag 🙂
Unser Beitrag
In meiner gemeinsamen Forschung mit dem Zentrum für Humangenetik und Genommedizin am Uniklinikum RWTH Aachen entwickeln und wenden wir Machine Learning Modelle an, um neue Erkenntnisse aus genomischen Daten zu gewinnen und so einen Beitrag für die so wichtige genommedizinsche Forschung und eine bessere Gesundheitsversorgung zu leisten. Darüber hinaus tragen wir durch den Aufbau und die Weiterentwicklung der Cloud‑Infrastruktur und der Data‑Lakehouse‑Architektur dazu bei, eine skalierbare Analyse genomischer Daten zu ermöglichen.
Wenn ihr Interesse an dieser Arbeit oder an möglichen Kooperationen haben oder Unterstützung braucht, kommt gerne auf uns zu.
Autor
 https://www.scieneers.de/wp-content/uploads/2026/10/Power-BI-Customs-Visuals-Blog-Post-Bild-1-scaled.jpg
1429
2560
shinchit.han@scieneers.de
https://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.png
shinchit.han@scieneers.de2026-10-09 16:40:342026-10-12 09:57:09Power BI Custom Visuals
 https://www.scieneers.de/wp-content/uploads/2026/10/Masterarbeit-Blog-Post-Bild-scaled.jpg
1429
2560
shinchit.han@scieneers.de
https://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.png
shinchit.han@scieneers.de2026-10-07 17:04:102026-10-07 17:04:17Time Series Foundation Models in Practice
 https://www.scieneers.de/wp-content/uploads/2026/09/Gemini_Generated_Image_pwnqigpwnqigpwnq-scaled.jpg
1429
2560
shinchit.han@scieneers.de
https://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.png
shinchit.han@scieneers.de2026-10-03 08:00:212026-10-09 16:38:47Rückblick: Unser Workshop zu Retrieval-Augmented Generation (RAG)
 https://www.scieneers.de/wp-content/uploads/2026/09/IMG_0354-2-scaled.jpg
1388
2560
shinchit.han@scieneers.de
https://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.png
shinchit.han@scieneers.de2026-10-02 07:35:342026-10-02 15:40:40Rückblick auf unser Herbstevent 2026
 https://www.scieneers.de/wp-content/uploads/2026/08/Gemini_Generated_Image_rg6ongrg6ongrg6o-1-scaled.jpeg
1429
2560
shinchit.han@scieneers.de
https://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.png
shinchit.han@scieneers.de2026-09-02 09:00:072026-09-04 09:32:15Data Product Ownership
 https://www.scieneers.de/wp-content/uploads/2026/08/Gemini_Generated_Image_fb66safb66safb66-scaled.png
1429
2560
Alina Dallmann
https://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.png
Alina Dallmann2026-08-12 18:21:492026-08-14 15:50:16Spec-Driven-Development
 https://www.scieneers.de/wp-content/uploads/2026/07/story_sickle_cell_no_title.png
1024
1536
Martin Danner
https://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.png
Martin Danner2026-07-08 17:14:282026-07-31 14:25:40Ein Buchstabe, der alles verändert: Die Geschichte der Sichelzellkrankheit
 https://www.scieneers.de/wp-content/uploads/2026/06/blog_post_genomic_haystack.png
1024
1536
Martin Danner
https://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.png
Martin Danner2026-06-04 15:26:032026-07-31 14:24:20Die Suche nach der Nadel im genomischen Heuhaufen
 https://www.scieneers.de/wp-content/uploads/2026/05/Screenshot-2026-05-22-090434.jpeg
692
1272
shinchit.han@scieneers.de
https://www.scieneers.de/wp-content/uploads/2020/04/scieneers-gradient.png
shinchit.han@scieneers.de2026-05-26 08:27:482026-05-26 08:35:31Dynamische Disposition in Straßenbahndepots durch Reinforcement Learning